


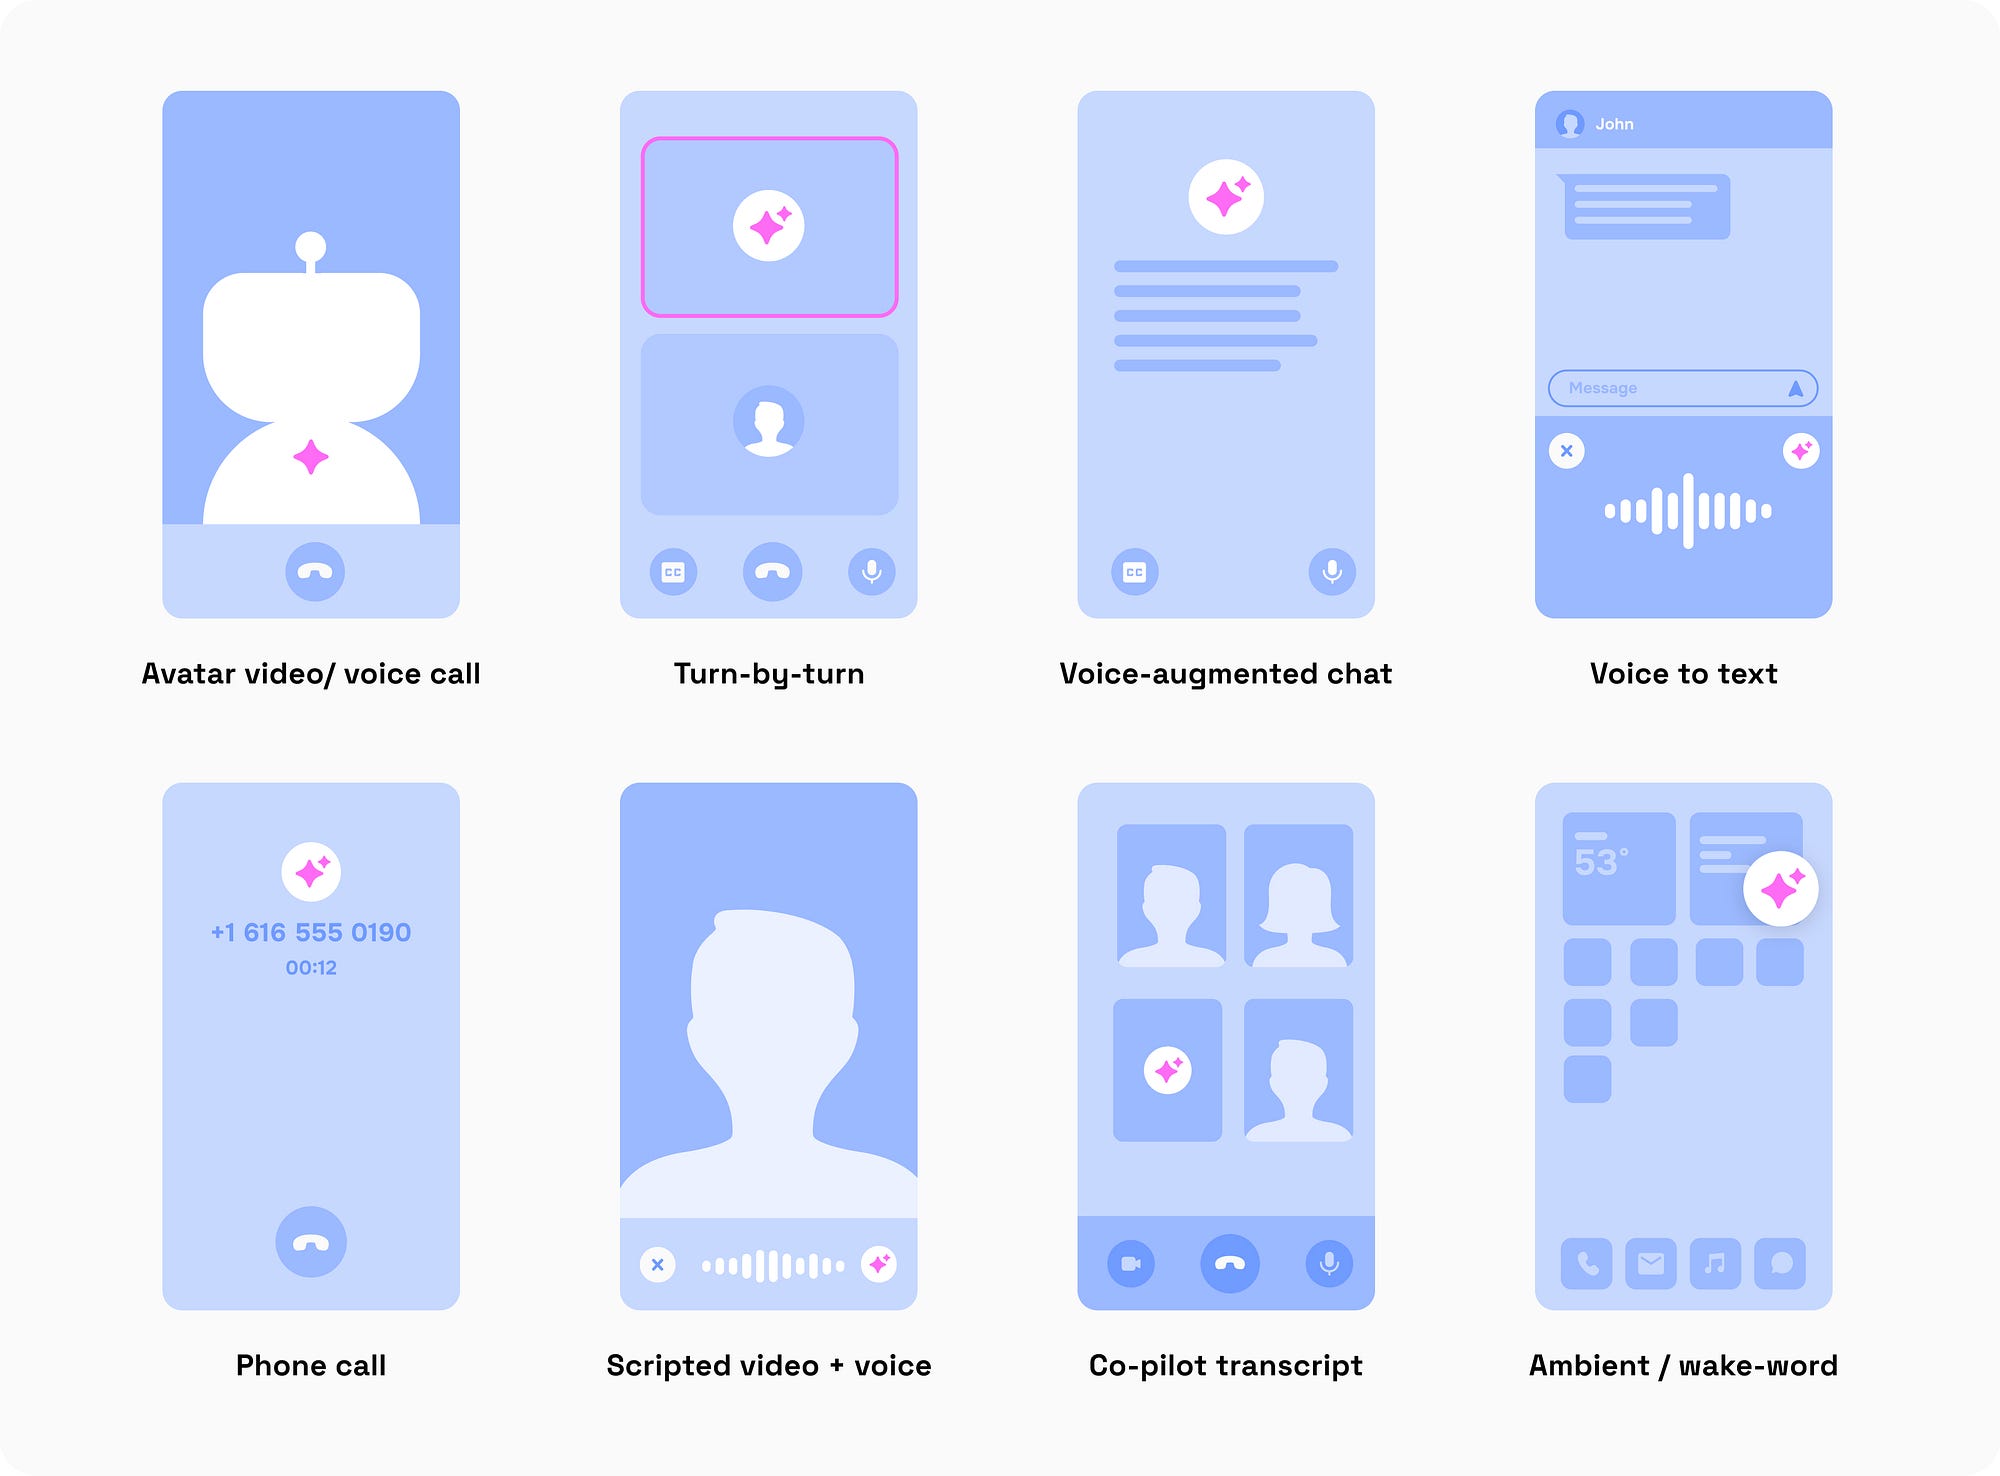
UX Collective’de 10 Eylül 2026’da yayımlanan yazısında Sharang Sharma, sesli yapay zeka ürünlerinde yerleşmeye başlayan sekiz arayüz kalıbını haritalıyor: avatar görüntülü görüşme, sıra tabanlı, yapay zeka telefon görüşmesi, sesle desteklenen sohbet, sesten metne, senaryolu video + ses, yardımcı pilot transkript ve ortam/uyandırma sözcüğü. Her kalıp ajana farklı bir rol biçiyor ve farklı tasarım kararları gerektiriyor.
Sharma yazıya 1922’de satılan ilk sesle çalışan oyuncakla başlıyor: Radio Rex. Kulübedeki köpek, “x” harfinin yaklaşık 500 Hz’lik ses enerjisi metal köprüyü titretip akımı kestiğinde dışarı fırlıyordu. Sonraki yüzyıl boyunca temel mantık değişmedi — sesi yakala, niyete eşle, tepki tetikle. Değişen şey, son yıllarda dil ve konuşma modellerinin gecikme, maliyet ve güvenilirlik tarafında yaptığı sıçrama.

Kalıpları ayıran iki soru
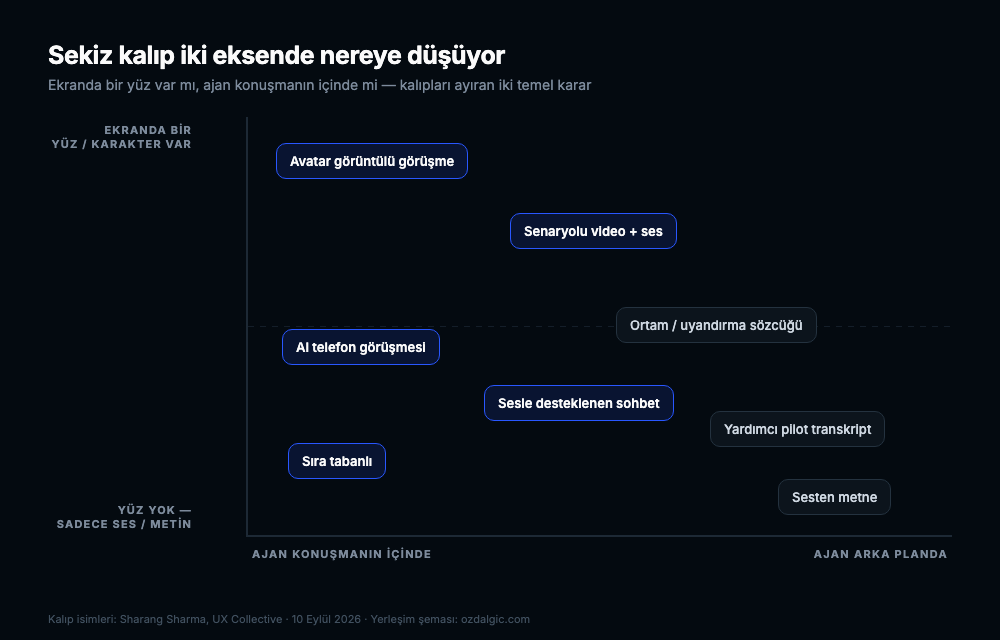
Sekiz kalıbı ezberlemek yerine iki soruyla ayırmak daha işe yarıyor:
- Ekranda bir yüz var mı? Avatar veya çekilmiş video, ajana “varlık” kazandırıyor; yüz yoksa bütün yük sese ve kelime seçimine biniyor.
- Ajan konuşmanın içinde mi, arka planında mı? Katılımcı olan ajan sıra alır ve sözü kesilebilir; gözlemci olan ajan yalnızca dinler ve sonradan çıktı üretir.

Sekiz kalıp tek tek
1. Avatar görüntülü görüşme
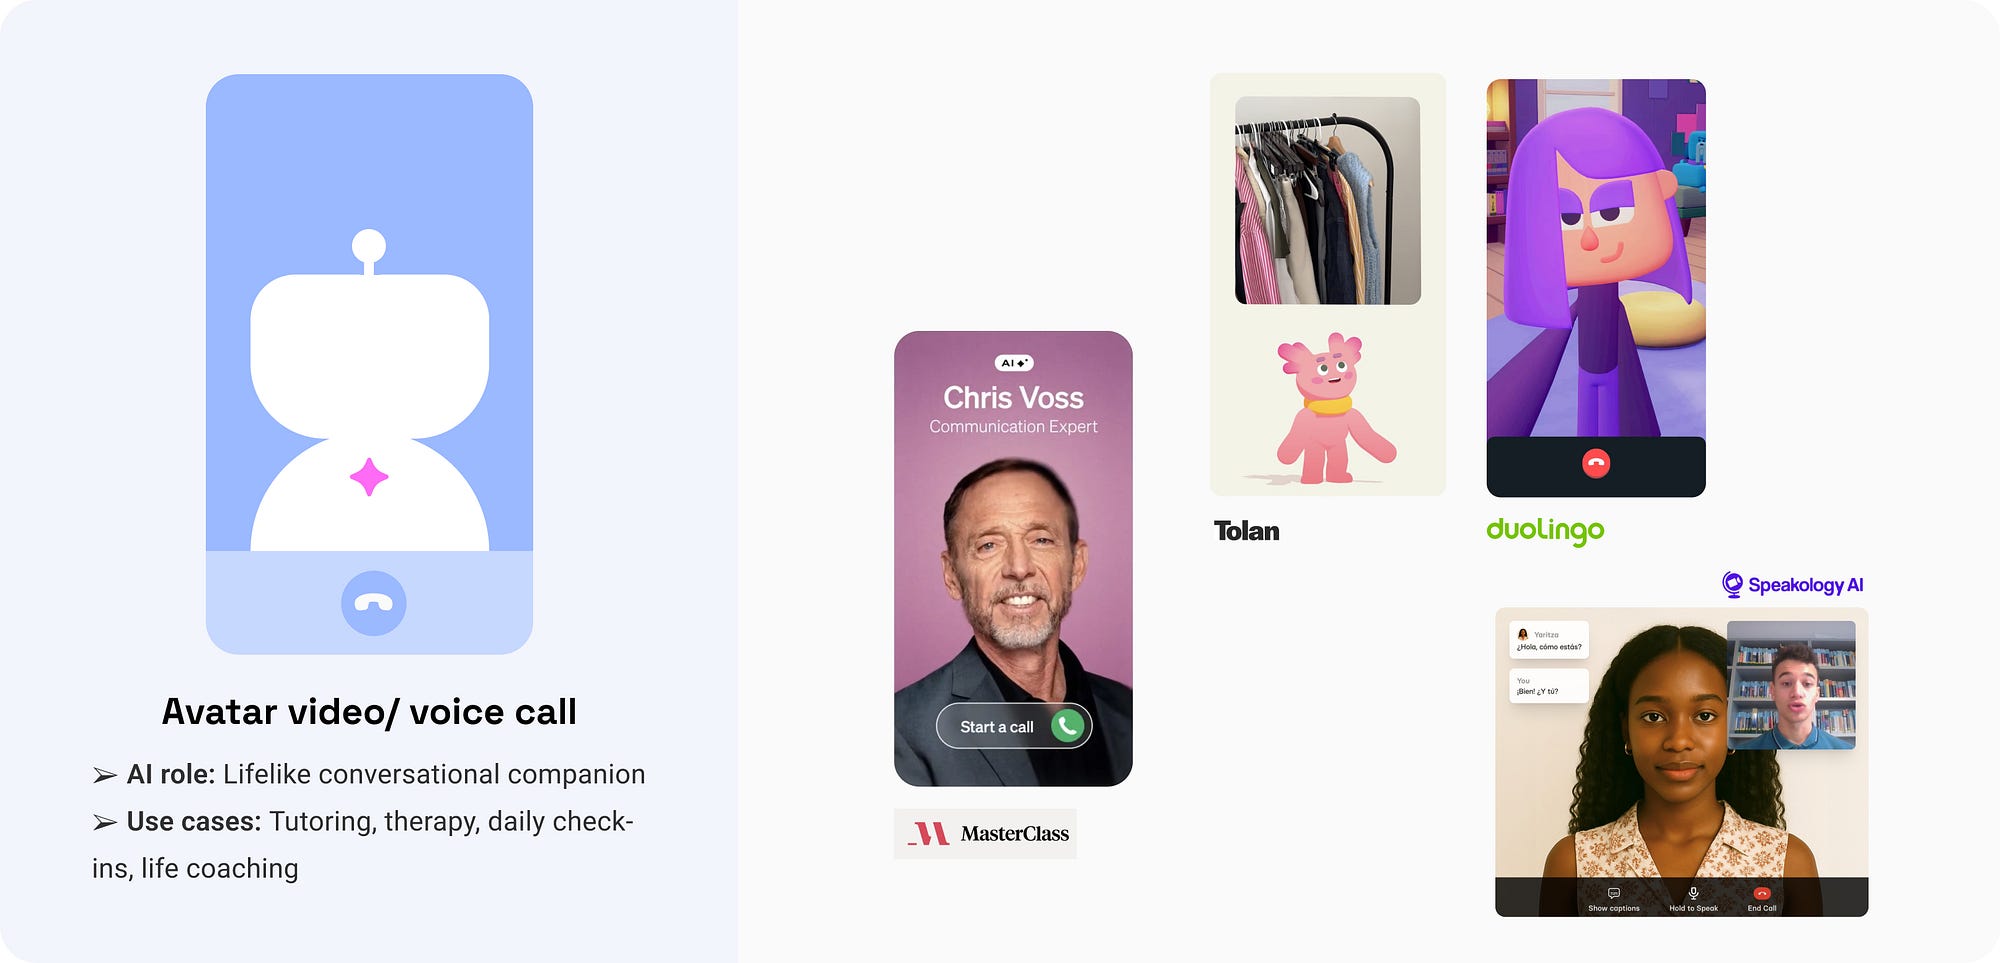
Deneyim bir görüntülü arama gibi kurgulanıyor: karşıda ya animasyonlu bir karakter ya da gerçekçi bir insan avatarı var. Duolingo’nun Lily ile görüntülü konuşması, MasterClass AI, Speakology gibi dil ve beceri koçluğu ürünleri; Tolan ve Replika’nın video modu gibi arkadaşlık/destek ürünleri bu kalıpta.
Ajanın rolü: Canlı bir sohbet arkadaşı. Gücü sesten değil, yüz yüze varlıktan geliyor — göz teması, dudak senkronu, boştaki mikro ifadeler.
Kritik karar: Gerçekçilik ile tekinsiz vadi arasındaki denge. Fotogerçekçi avatarlar gecikme veya dudak senkronu hatası yaptığında yanılsama kırılıyor; buna karşılık ünlü harflere göre ağız şekli eşleyen 2B animasyonlu personalar hem ucuz hem dayanıklı. Sharma’nın aktardığına göre Tolan’ın kendi kullanıcı anketinde katılımcıların %85,6’sı ürünün duygusal olarak zor bir dönemi atlatmaya yardım ettiğini, %72,5’i bir ilişkiyi yönetmeye veya iyileştirmeye katkı sağladığını söylemiş. 
 Bu veri şirketin kendi bildirdiği bir ankete dayanıyor, bağımsız bir çalışma değil.

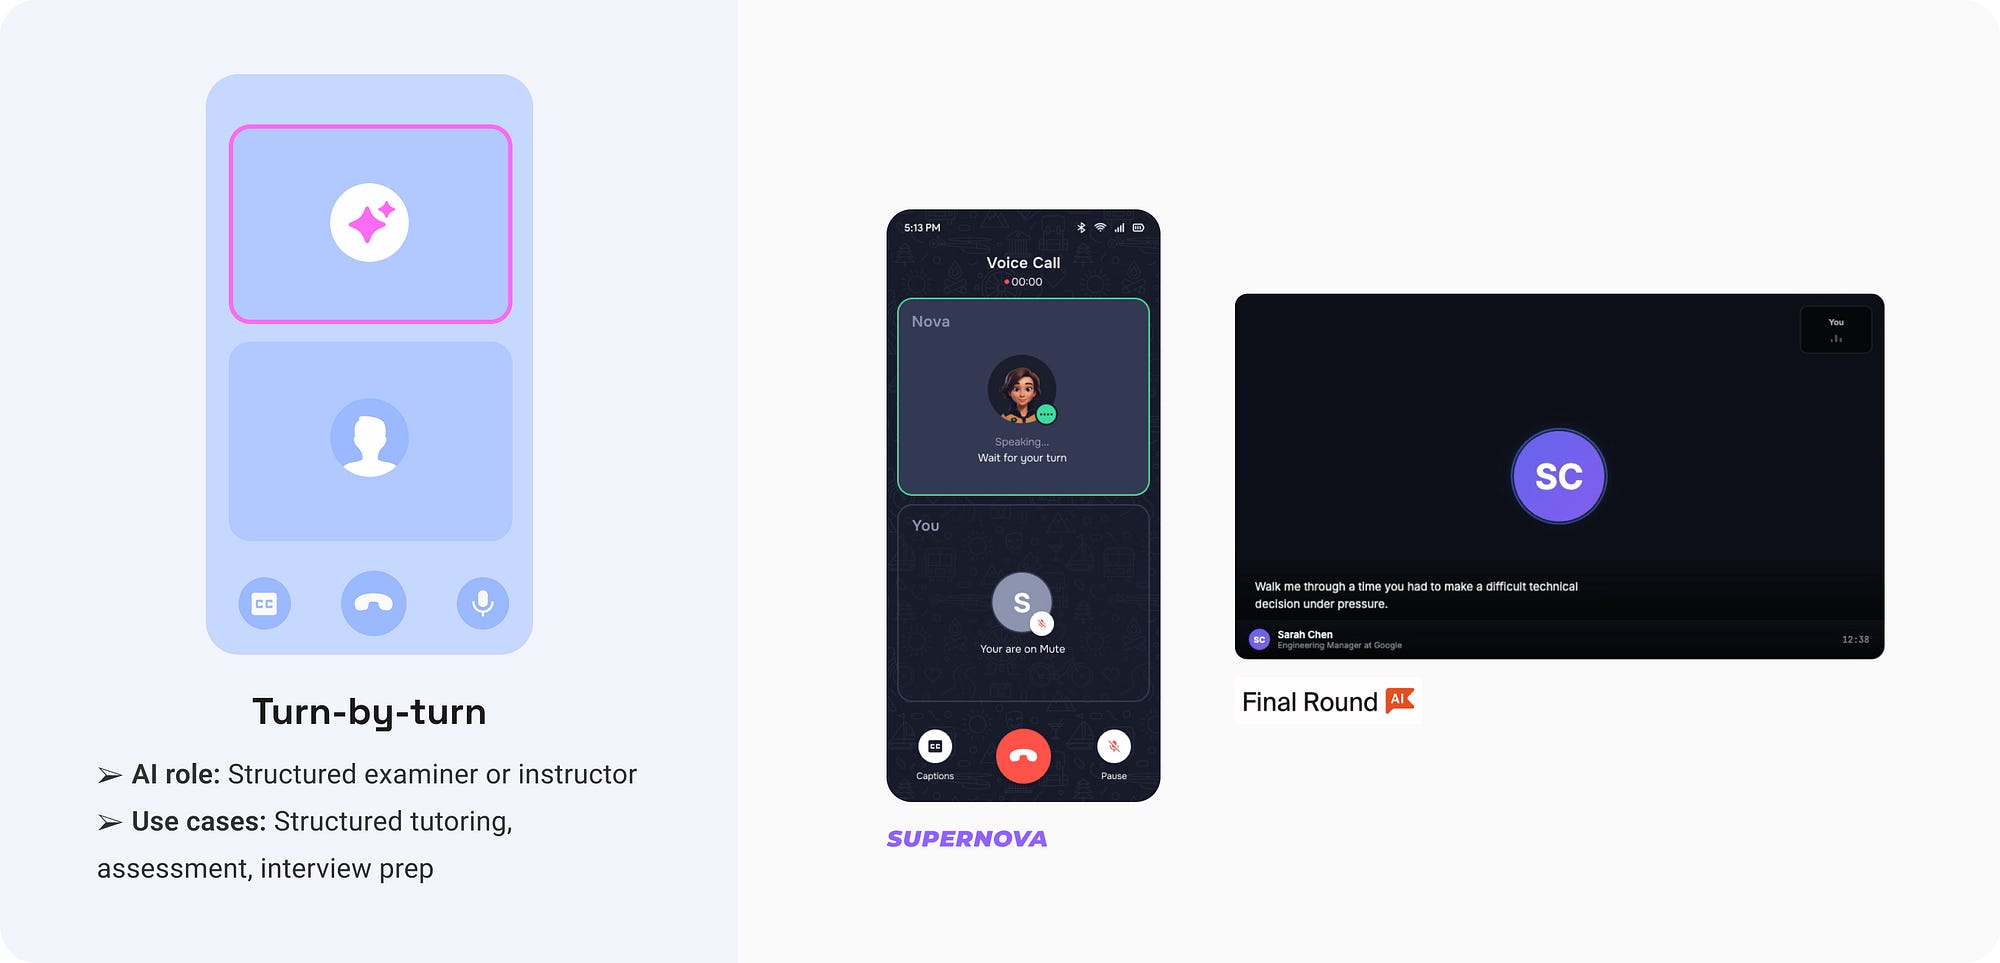
2. Sıra tabanlı (turn-by-turn)
Katı sıra düzeni ve kimin konuştuğunu gösteren net görsel durumlar. HireVue AI, Final Round AI, Supernova gibi mülakat hazırlığı ve beceri değerlendirme ürünleri burada — çünkü cevapla, değerlendir, geri bildirim ver döngüsü gerçek bir sınavın ritmini taklit ediyor.
Kritik karar: Yüzün olmaması bilinçli bir tercih — dikkat sıranın kendisinde kalıyor. Buna karşılık sıra devri sinyali kusursuz olmalı: renk, metin ve geçiş animasyonu birlikte çalışmalı ki kullanıcı hiçbir an “sıra kimde?” diye düşünmesin. Kalıbın sınırı da bu: söz kesme yok, dolayısıyla sadece temiz sıraların anlamlı olduğu dar kullanımlarda işe yarıyor. İlerleme göstergesi veya süre bilgisi eklemek de neredeyse zorunlu.

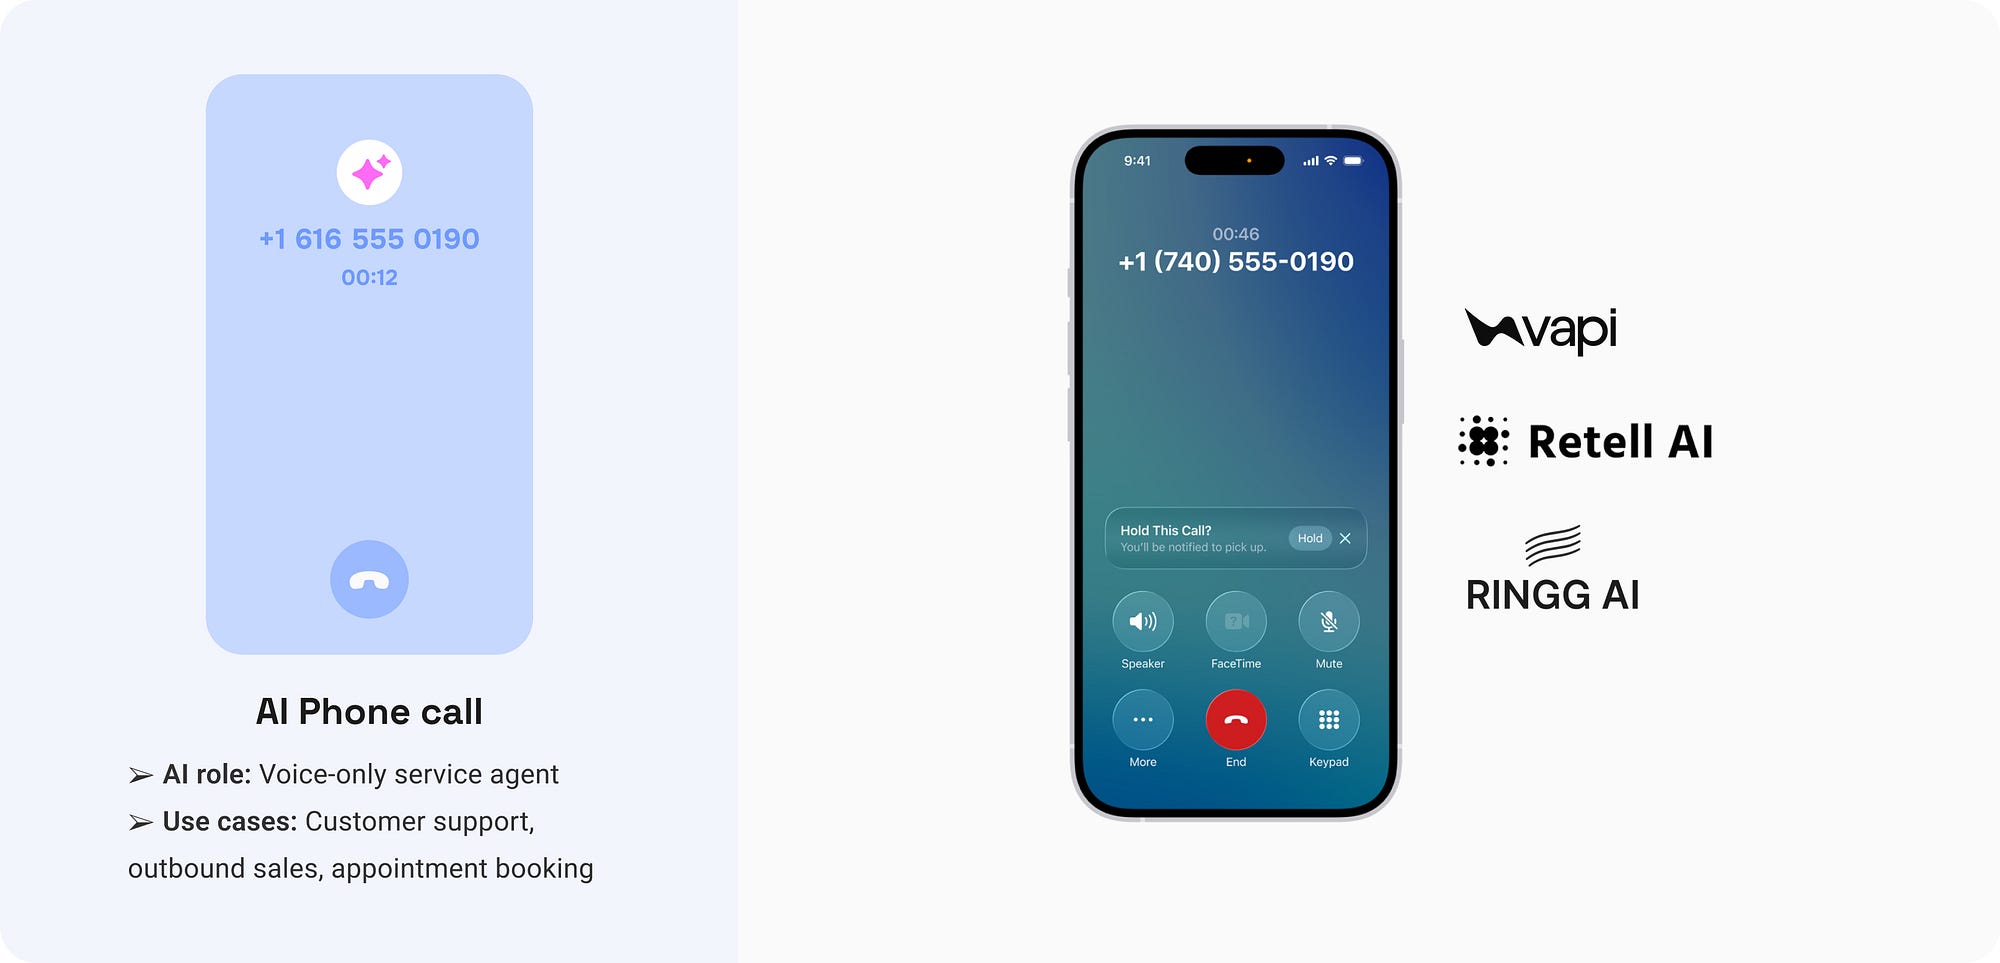
3. Yapay zeka telefon görüşmesi
Gerçek bir telefon görüşmesini taklit eden kalıp: müşteri desteği otomasyonu, potansiyel müşteri nitelendirme, randevu alma, anket. Ringg AI, Retell ve Vapi gibi B2B platformlar bu ajanları satıyor; hiRobin ve equalAI gibi B2C uygulamalar ise gündelik telefon görüşmelerini devralıyor.
Kritik kararlar:
- Konuşma yayı: Gelen destek çağrısı selamlama → niyet → çözüm → kapanış şeklinde ilerlerken, giden satış çağrısı önce kendini tanıtıp izin almak zorunda.
- Kişilik sadece kelimelerde: Yüz yok, dolayısıyla sıcaklık kelime seçimi ve tempoyla kuruluyor. Vapi’nin kendi aktardığı veriye göre bir ajanın metni kurumsal senaryodan “iş arkadaşı gibi konuşan” bir dile çevrildiğinde giden çağrı dönüşümü %14’ten %22’ye çıkmış — akış hiç değişmeden.
 Sağlayıcının kendi bildirdiği rakam.
- Arayan geri kaydıramaz: Ekranda hiçbir şey kalmadığı için randevu tarihi, isim, tutar gibi bilgiler ajanın bir sonraki cümlesinde sesli olarak teyit edilmeli: “Anladım, randevunuzu 15 Ocak’a alıyorum.”
- Yazılması gereken her şey kanal değiştirmeli: Bağlantı, referans numarası ve adres sesle aktarılamaz; SMS veya e-postaya geçmek gerekiyor.


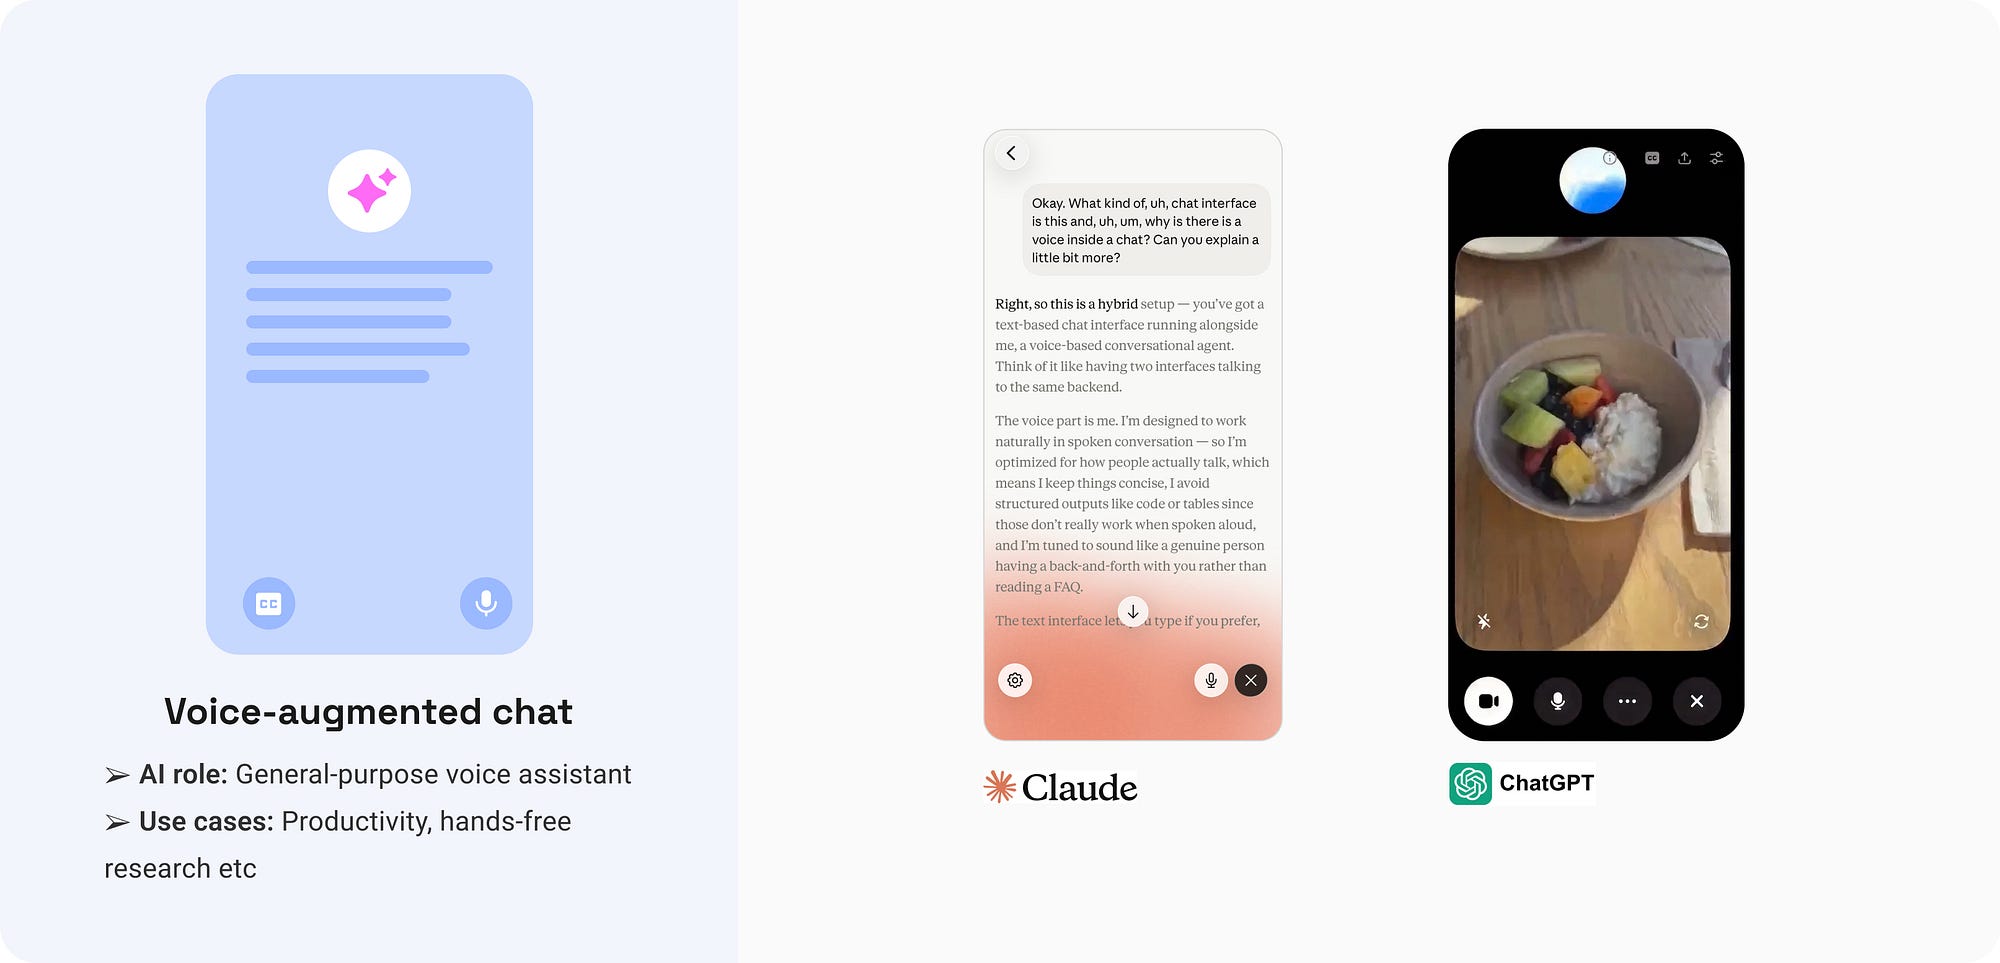
4. Sesle desteklenen sohbet
Genel amaçlı bir metin sohbetinin üzerine eklenen ses katmanı — aynı ajan, sadece yazmak yerine konuşuyor. ChatGPT’nin sesli modu, Claude’un sesli modu ve Gemini Live bu kalıpta.
İki biçimi var: Tam ekran sesli mod etkileşimi tamamen devralıyor, sohbet akışı kayboluyor. Satır içi ses ise mevcut sohbetin içinde duruyor; konuşma girdisi ve çıktısı metinle yan yana yaşıyor. İkisi de aynı iş parçacığını, hafızayı ve kimliği paylaşıyor.
Sınırı: Kod, tablo ve artefakt gibi seslendirilemeyen çıktılar. Kalıp bunları ya sessizce kırpıyor ya da kullanıcıyı metin sohbetine geri yönlendiriyor — her iki durumda da sesli akış kırılıyor.

5. Sesten metne
Karşılıklı konuşma yok: kullanıcı mikrofona konuşuyor, metin bir giriş alanında beliriyor. iOS ve Android klavyesindeki dikte, ChatGPT ve Claude’un metin kutusundaki dikte, Wispr Flow ve Spokenly gibi amaca özel uygulamalar bu kalıpta.
Ajanın rolü yok — burada karakter değil, saf bir araç var. Dolayısıyla ürünün tamamı çıktı doğruluğu. Bağlam (resmî mi, samimi mi), özel isimler ve ton doğru düşmezse kullanıcı elle düzeltmek zorunda kalıyor.
Wispr Flow’un kendi iddiasına göre çıktılarının %90’ı hiç düzenlenmeden gönderilebiliyor; aynı karşılaştırmada OpenAI için verilen oran %71. Bağımsız incelemelerde gündelik konuşmada yaklaşık %97 doğruluk bildirildiği aktarılıyor. Bunlar üreticinin paylaştığı rakamlar — bağımsız doğrulanmış ölçüm değil.
İlginç tasarım gerçeği: Sesle düzeltmek yazmaktan yavaş. Bu yüzden hem Wispr Flow hem Spokenly kendi iOS klavyelerini gönderiyor; düzeltmeyi sesle yaptırmak yerine klavyeye bırakıyorlar.

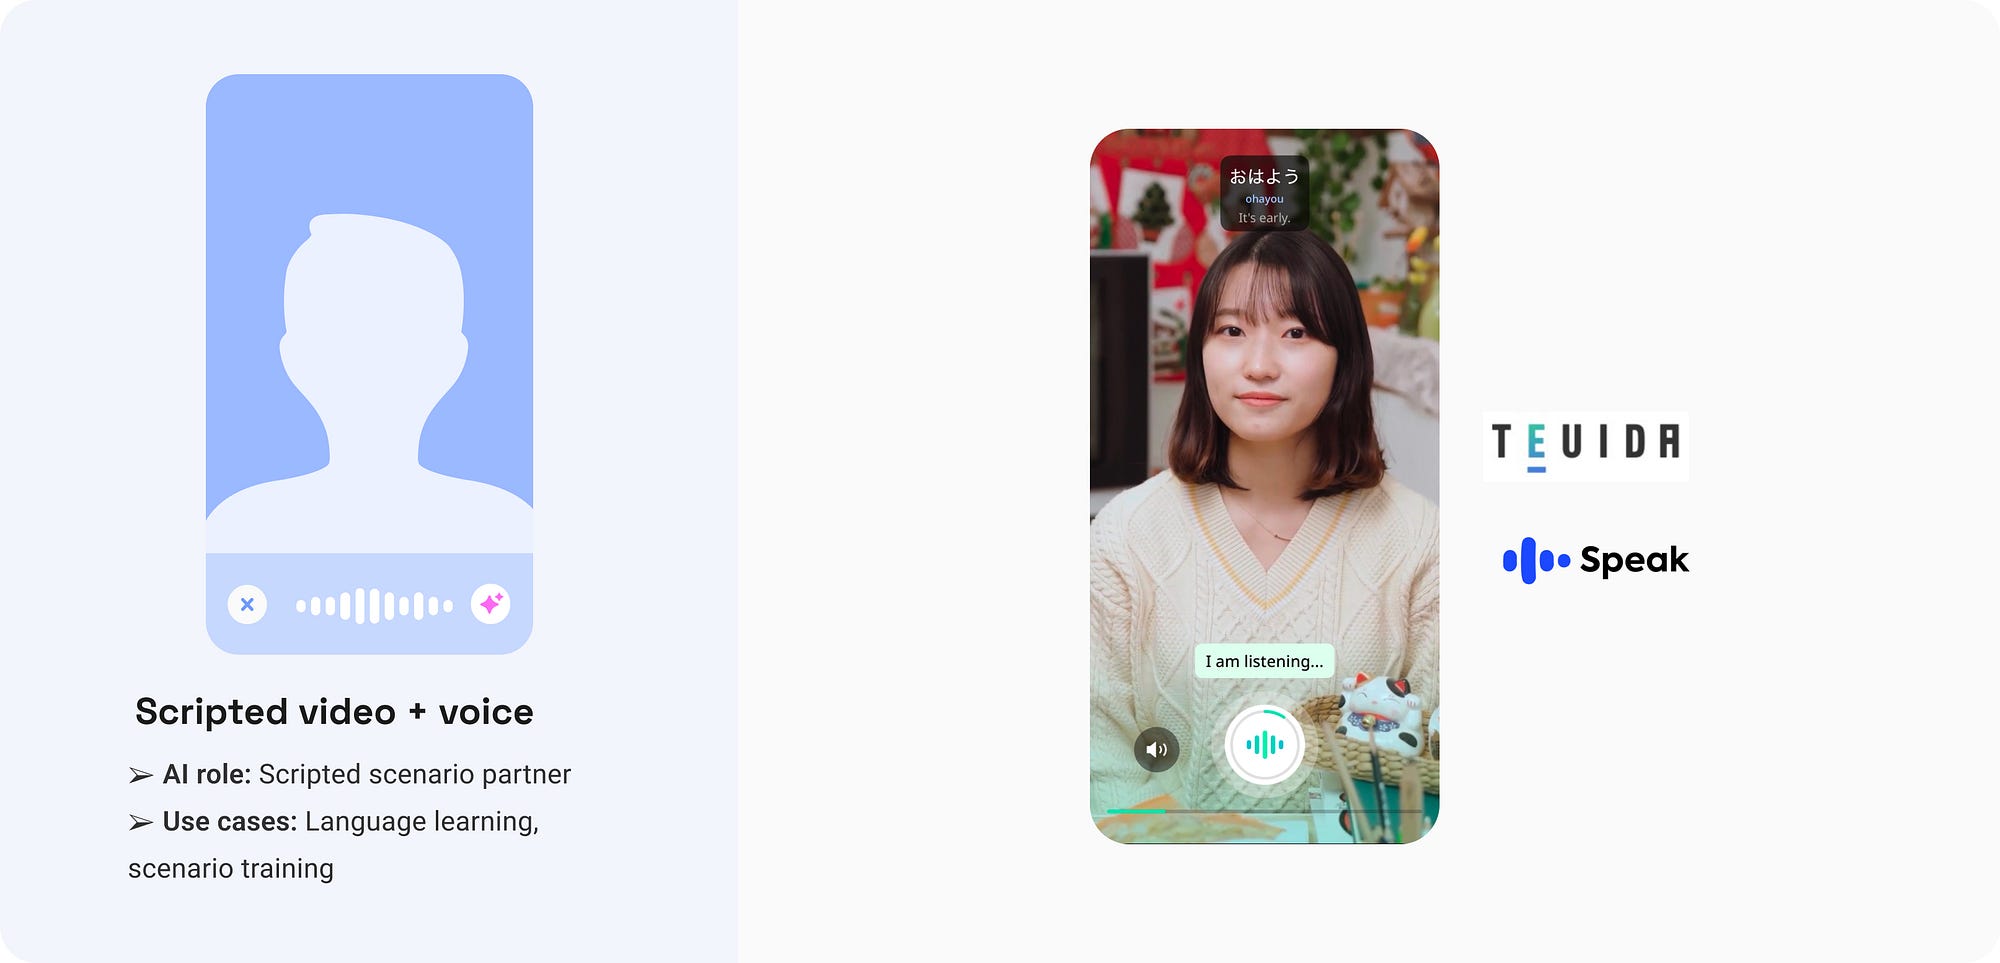
6. Senaryolu video + ses
Önceden çekilmiş video ile sesli girdinin birleşimi. Ekrandaki eğitmen konuşuyor, sıra size gelince duruyor, söylediğinize göre önceden çekilmiş bir dalı oynatıyor. Yapay zeka cevap üretmiyor; sadece konuşmanızı değerlendirip hangi klibin oynayacağını seçiyor. Speak ve Teuida bu kalıbı en net kuran dil öğrenme uygulamaları.
Gücü: Çekilmiş görüntü gerçek bir mekân duygusu yaratıyor. Teuida sahnelerini birinci şahıs bakış açısıyla çekiyor — eğitmen doğrudan kameraya, yani size konuşuyor. Sınırı: Her yeni dal ayrı bir çekim demek. Yeni içerik veya yeni bir dil eklemek maliyeti katlıyor; çalışmayan bir repliği düzeltmek “düzenleme” değil “yeniden çekim” gerektiriyor.

7. Yardımcı pilot transkript
Konuşmayı dinleyip yapılandırılmış çıktı üreten ajan: kararlar, aksiyon maddeleri, özet, kim ne dedi, takip e-postası. Granola, Otter ve Fireflies tüketici tarafında; Gong ve Chorus satış görüşmelerinde itiraz ve duygu analizi için aynı işi yapıyor. Kalıp sağlık danışmalarına, hukuki ifadelere ve kullanıcı araştırmasına da uzanıyor.
Ajan katılımcı değil, gözlemci. Ama ne kadar görünür bir gözlemci olduğu her şeyi değiştiriyor:
 Aktif: Granola görüşme sırasında canlı transkript gösteriyor, soru sormanıza izin veriyor, öneri çıkarıyor — toplantının akışını şekillendiriyor.
- Pasif: Fireflies sessizce dinliyor, bulduklarını sonradan gösteriyor.
 Görünmez: Cluely.ai gibi ürünler değerlendirme ve mülakat bağlamında hiçbir kayıt göstergesi olmadan çalışıyor — şeffaflık açısından sorunlu.
 Aktif: Granola görüşme sırasında canlı transkript gösteriyor, soru sormanıza izin veriyor, öneri çıkarıyor — toplantının akışını şekillendiriyor.
 Görünmez: Cluely.ai gibi ürünler değerlendirme ve mülakat bağlamında hiçbir kayıt göstergesi olmadan çalışıyor — şeffaflık açısından sorunlu.
Katılma biçimi davranışı değiştiriyor: Granola sesi doğrudan cihazdan sessizce alırken, Zoom ve Fireflies toplantıya görünür bir bot sokuyor. İnsanlar katılımcı listesinde bir bot gördüklerinde daha sessiz ve daha dikkatli oluyor. Otomatik paylaşım da ayrı bir karar: hızlı ama yanlış duyulmuş bir isim ya da hiç olmamış bir aksiyon maddesi sizin adınızla gidebilir.


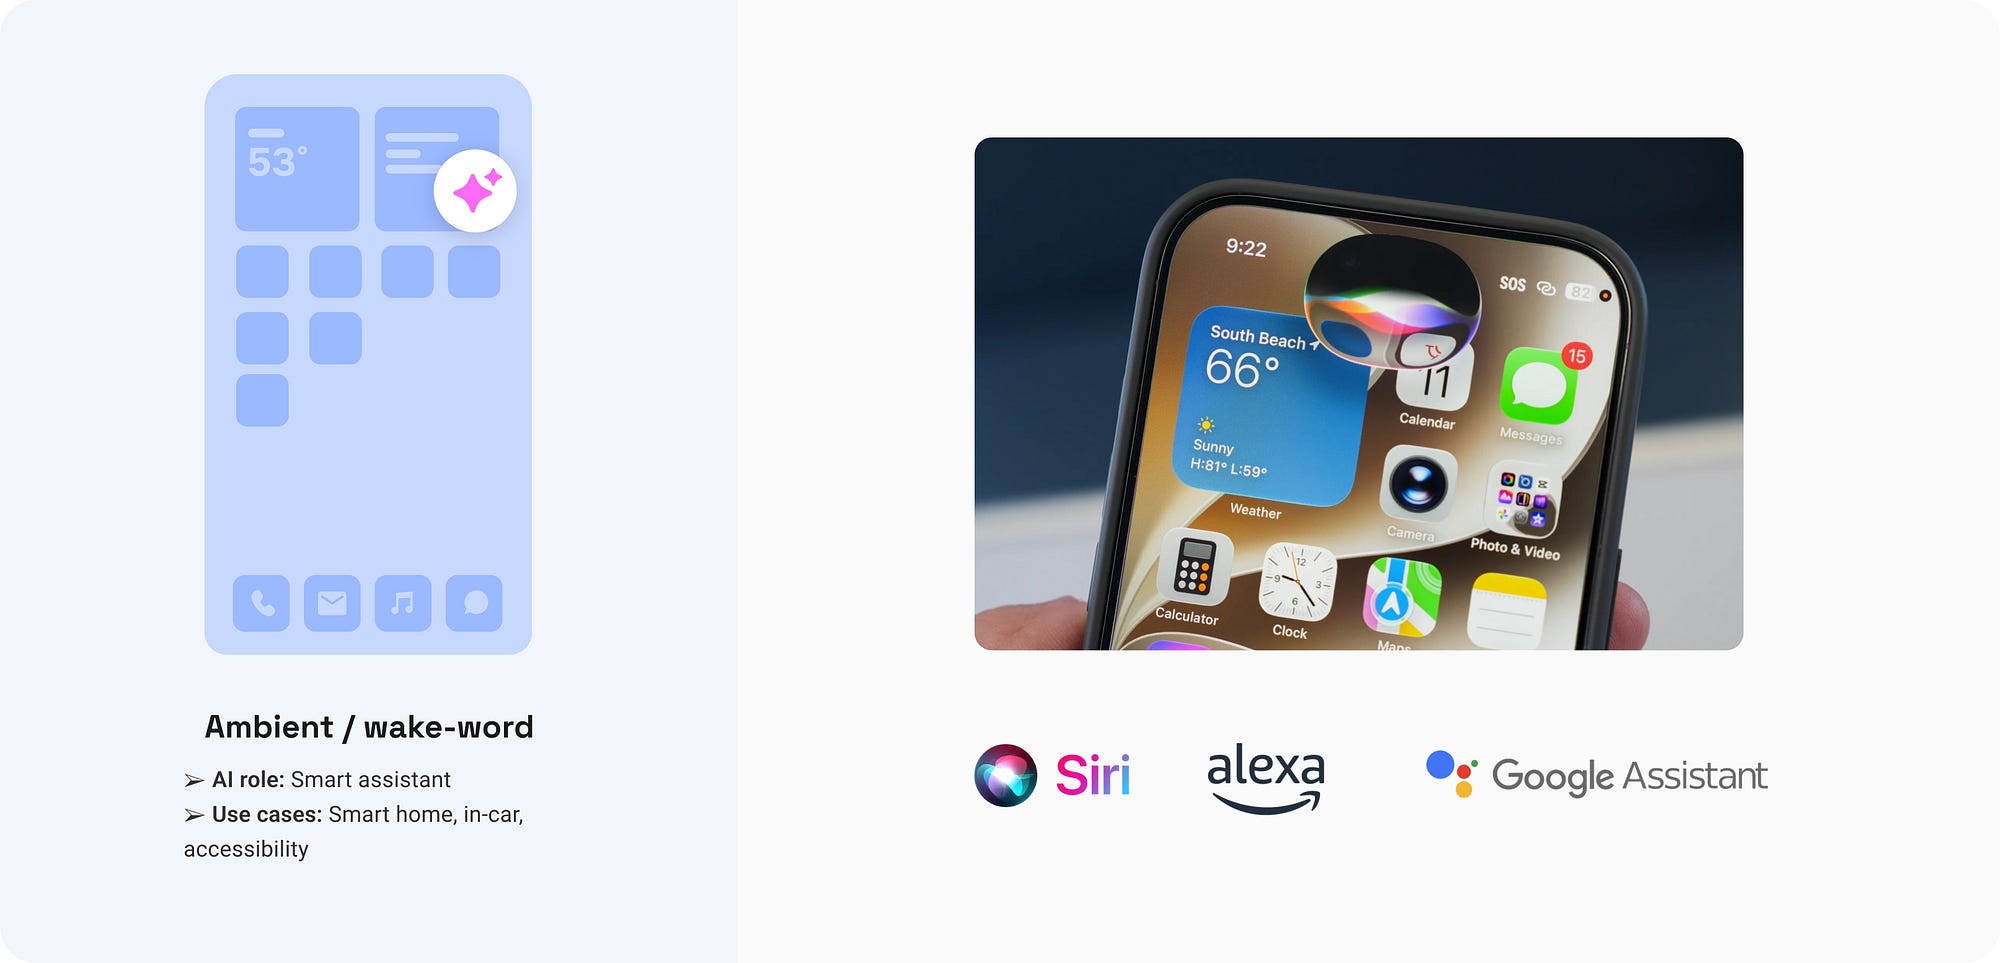
8. Ortam / uyandırma sözcüğü
Telefon, akıllı hoparlör, gözlük, araç sistemi veya sosyal robot. Kalıbın kökeni 1961’e, IBM’in sınırlı bir sözcük dağarcığını tanıyan Shoebox makinesine dayanıyor. Siri, Alexa ve Google Assistant bu çizginin devamı.
Ajanın rolü komut yürütücü — düşünme ortağı değil. Uyandırma sözcüğü kısa bir dinleme penceresi açıyor, tek bir söz ve kısa bir cevap geliyor. Oturum yok, iş parçacığı yok: her etkileşim soğuk başlıyor.
- Uyandırma sözcüğünü doğru kurmak her şeyin önünde geliyor. Kimse konuşmamışken tetiklenmek cihazı aptal gösteriyor; konuşulduğunda tetiklenmemek çileden çıkarıyor.
- Yeteneği öğretecek kalıcı bir arayüz yok. Onboarding, “şunları deneyin” kartları ve proaktif öneriler bu boşluğu kapatmaya çalışıyor; Sharma’ya göre hiçbiri iyi sonuç vermedi.
- Cevaplar kısa olmak zorunda. Kullanıcı söyleneni yeniden okuyamıyor; birkaç cümleyi aşan her şey ezberlenmek zorunda kalıyor.

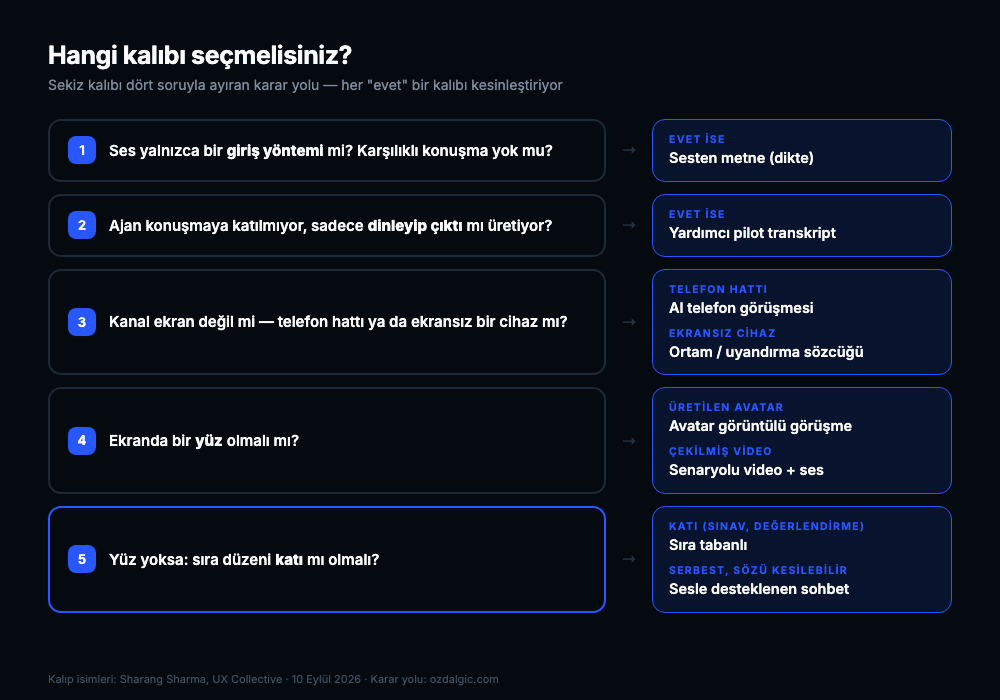
Hangi kalıbı seçmelisiniz?
Kalıplar birbirinin alternatifi değil; farklı sorulara verilmiş cevaplar. Seçimi beş soruyla daraltabilirsiniz:

Sırayı kim devralır: PTT, VAD ve söz kesme
Sesli arayüzde kullanıcının en çok hissettiği karar, konuşma sırasının nasıl el değiştirdiği. Üç mekanizma var:
- Bas-konuş (PTT): Gürültülü ortam, uzun komut ve yarıda kesilmemesi gereken düşünce için uygun.
- Ses etkinliği algılama (VAD): Eller meşgulken ve kısa gidiş-gelişlerde uygun; erken kesme riski taşıyor.
- Söz kesme (barge-in): Telefon ve avatar görüşmesi gibi gerçek zamanlı kalıplarda zorunlu, sıra tabanlı kalıpta bilinçli olarak kapalı.


Sekiz kalıbın ortak sınırı
Kalıplar farklı ama aynı üç duvara çarpıyorlar:
- Ses geri kaydırılamaz. Telefon görüşmesinde de ortam cihazında da kullanıcı söyleneni yeniden okuyamıyor — bu yüzden her ikisi de duyduğunu ve yapacağını sesli teyit etmek zorunda kalıyor.
- Yetenek görünmez. Kalıcı bir arayüz olmadığında kullanıcı ne isteyebileceğini bilemiyor; ortam kalıbının on yıllık çözülememiş problemi bu.
- Karmaşık çıktı sese sığmıyor. Kod, tablo ve uzun liste ya kırpılıyor ya kullanıcıyı ekrana geri yolluyor.
Sharma’nın kapanıştaki tespiti şu: yüzyılın büyük kısmında sesli arayüzler niyet eşleştirme problemini çözüyordu. O kısım büyük ölçüde çözüldü. Şimdi cevaplanması gereken sorular tasarım soruları — ajanın yüzü olmalı mı, nasıl konuşmalı, gerçek zamanlı mı katılmalı yoksa sessizce mi izlemeli. Olgunlaşan bir mecrada “ajanın ne yapabildiğini” tasarlamak kadar “ne olarak göründüğünü” tasarlamak da belirleyici hâle geliyor.
Sık sorulan sorular
VAD (ses etkinliği algılama) nedir?
VAD, kullanıcının ne zaman konuşmaya başlayıp ne zaman durduğunu gerçek zamanlı algılayan mekanizmadır. Sesli arayüzlerde konuşma sırasının otomatik el değiştirmesini ve kullanıcının ajanın sözünü kesebilmesini sağlar. Alternatifi, kullanıcının bir düğmeyi basılı tuttuğu bas-konuş (PTT) yöntemidir.
Bas-konuş mu, VAD mi kullanmalıyım?
Bas-konuş gürültülü ortamlarda ve uzun komutlarda daha güvenli; kullanıcının sözü yarıda kesilmez. VAD ise eller meşgulken ve kısa gidiş-gelişlerde daha doğal çünkü düğmeye basmak pratik değildir. Ürününüz hareket hâlinde kullanılıyorsa VAD, masa başında uzun dikte içinse PTT daha uygundur.
Toplantı botu görünür mü olmalı, gizli mi çalışmalı?
Görünürlük davranışı değiştiriyor: katılımcı listesinde bot gören insanlar daha sessiz ve daha temkinli konuşuyor. Cihazdan sessizce ses alan ürünler bu etkiyi ortadan kaldırıyor, ancak kayıt göstergesi hiç olmayan yaklaşımlar şeffaflık açısından sorunlu. Kararı toplantı kültürüne ve yasal çerçeveye göre vermek gerekiyor.
Sesli ajanda avatar kullanmak şart mı?
Hayır. Avatar yalnızca varlık hissinin işin bir parçası olduğu kullanımlarda (dil koçluğu, arkadaşlık, terapi benzeri destek) değer katıyor. Değerlendirme, destek çağrısı ve dikte gibi kullanımlarda yüz dikkat dağıtıyor; bu kalıplarda bütçe ses kalitesine ve sıra yönetimine harcanmalı.
Kaynaklar
- Sharang Sharma, “8 voice AI UX patterns” — UX Collective, 10 Eylül 2026
- Yazının kendi kaynakçasında anılan çalışmalar: LiveKit’in sıra algılama yazısı, OpenAI Realtime API dokümantasyonundaki VAD tanımı, Google konuşma tasarımı rehberi ve Vapi konuşma tasarımı playbook’u
Bu yazı 11 Eylül 2026’da hazırlandı. Şirketlerin kendi paylaştığı oranlar metin içinde ayrıca işaretlendi. İlgili okumalar: Butonun ölümü tartışması, Gemini’nin akıllı dikte özelliği ve NN/g’nin yapay zeka sözlüğü.
Bir Yorum Yazın