


AI prototipleme, tasarım kararlarınızı ayrıntılı bir prompt’a çevirip Cursor, v0 ya da Figma Make gibi araçlara gerçek ürün gibi davranan çalışan bir arayüz ürettirmektir. Nielsen Norman Group’un 11 Eylül 2026 tarihli makalesine göre bu yöntemin asıl kazancı hız değil zamanlama: filtre, dashboard ve konuşma tabanlı arayüz gibi elle prototiplenmesi pratikte imkânsız ekranları, geliştirme başlamadan önce gerçek kullanıcıyla test edebiliyorsunuz.
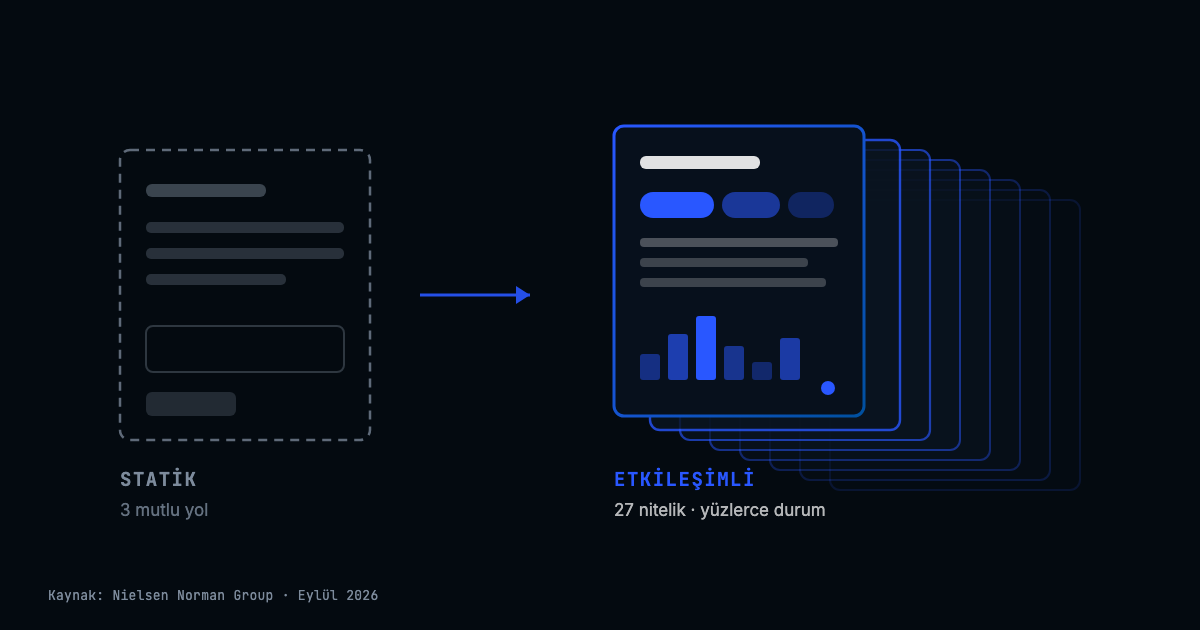
Makaleyi yazan Megan Chan’in çerçevesi net: AI araçları ortaya çıkmadan önce ekiplerin çoğu yalnızca birkaç “mutlu yol”u kapsayan basit bir prototipi test ediyor, kullanıcıların sistemle gerçekte nasıl etkileştiğini görmek için geliştiricilerin ürünü kurmasını bekliyordu. Bu bekleyişin bedeli, düzeltmenin en pahalı olduğu anda öğrenmekti.
Statik prototip karmaşık arayüzde nerede duvara toslar?
Sorun sadakat seviyesi değil, durum sayısı. Bir filtre arayüzünde her açma-kapama, her kombinasyon, her boş sonuç ekranı ayrı bir durumdur; bunları elle çizmek kombinasyon patlaması demektir. NN/g’nin aktardığı üç somut belirti şöyle:

 Katılımcı yorum yapmaktan kaçınır. Purdue ekibinin gözlemi: statik tasarımlarda katılımcılar daha az spesifik geri bildirim verdi ve tasarımları derinlemesine eleştiri için fazla erken buldu.
- Sistemin cevabı test edilemez. Filtre tasarımının kritik kısmı, kullanıcı filtreyi uyguladığında veya kaldırdığında sistemin ne yaptığıdır — statik ekran bunu hiç göstermez.
- Belirsiz çıktı taklit edilemez. Konuşma tabanlı bir AI arayüzü aynı girdiye farklı cevaplar üretebilir. Önceden çizilmiş ekran setine dayanan araçlar bu davranışı kuramaz.
 Katılımcı yorum yapmaktan kaçınır. Purdue ekibinin gözlemi: statik tasarımlarda katılımcılar daha az spesifik geri bildirim verdi ve tasarımları derinlemesine eleştiri için fazla erken buldu.
Buradan çıkan ayrım, “AI prototipi her zaman daha iyidir” değil. Basit arayüzlerde statik prototipler birçok araştırma sorusunu hâlâ cevaplıyor. Ayrım, sorunun ne olduğuna bağlı:


Üç vaka: Ramp’ta iki, Purdue’da bir
Masraf politikası editörü: üç haftada konseptten demoya
Fintech şirketi Ramp’ın kıdemli ürün tasarımcısı Pavan Garidipuri, yöneticilerin harcama kurallarını yönettiği masraf politikası editörünü yeniden tasarlarken Cursor kullandı. Tercihin sebebi basitti: etkileşim tasarımını elle prototiplemek fazla karmaşıktı. Yeniden tasarımın merkezinde politikayı AI sohbeti üzerinden düzenleme deneyimi vardı ve sohbet temelli düzenleme dinamik arayüz cevaplarına dayandığı için statik ekranlarla simüle edilemiyordu.
Kullanılabilirlik testinde katılımcılara, kendi temizlenmiş verileriyle yüklenmiş çalışan bir prototip linki verildi. NN/g’nin aktardığına göre kritik bulgu şuydu: düzenlemelerin izlenme ve gösterilme biçimi kullanıcıları şaşırtıyordu. Garidipuri’ye göre ekibi bu sorunu gerçek arayüze yakın etkileşimli bir prototip olmadan bulamazdı. Proje konseptten demoya üç haftada ilerledi ve ekibin yılın kalanına ait yol haritasını değiştirdi.
Konuşma tabanlı masraf akışı: beklenmedik isteklerin testi
Yine Ramp’ta ürün tasarımcısı Andrew Lucas, konuşma tabanlı bir masraf raporlama akışını prototiplemek için Cursor’ı gerçek bir ajana bağladı — yani prototip, gerçek ürün gibi belirli olmayan çıktılar üretiyordu. Kazanç doğrudan araştırma tarafında: katılımcılar önceden belirlenmiş bir yolu izlemek yerine istedikleri her şeyi yazabildi, araştırmacılar da ajanın beklenmedik isteklerle nasıl başa çıktığını gördü. Bu tür sorunlar ancak neredeyse nihai bir sürüm test edildiğinde yüzeye çıkıyor.
Trafik mühendisleri için filtre arayüzü: aynı proje, iki faz
Purdue Üniversitesi’nden araştırmacılar, otoyol trafik mühendislerinin karmaşık veriyi analiz etmesi için bir filtreleme arayüzü geliştirdi. Veri setinde olay başına 27 nitelik vardı ve bunların bir kısmı iç içe alt niteliklere sahipti. Ekip aynı projeyi iki farklı yöntemle prototipledi:
- Faz 1 — elle çizilmiş statik ekranlar. Figma’da AI yardımı olmadan düşük sadakatli wireframe’ler kuruldu. Görsel tasarım hakkında geri bildirim alındı ama kimsenin filtrelerle nasıl etkileşeceği gözlemlenemedi.
- Faz 2 — AI ile üretilmiş etkileşimli prototip. Arayüz v0 ve Bolt ile yeniden kuruldu; araçlara hem spesifik tasarım gereksinimleri hem de AI’a ürettirilmiş sentetik bir veri seti verildi. Katılımcılar arayüzle bitmiş ürün gibi etkileşti ve ekibin çözebileceği somut problemler bildirdi.

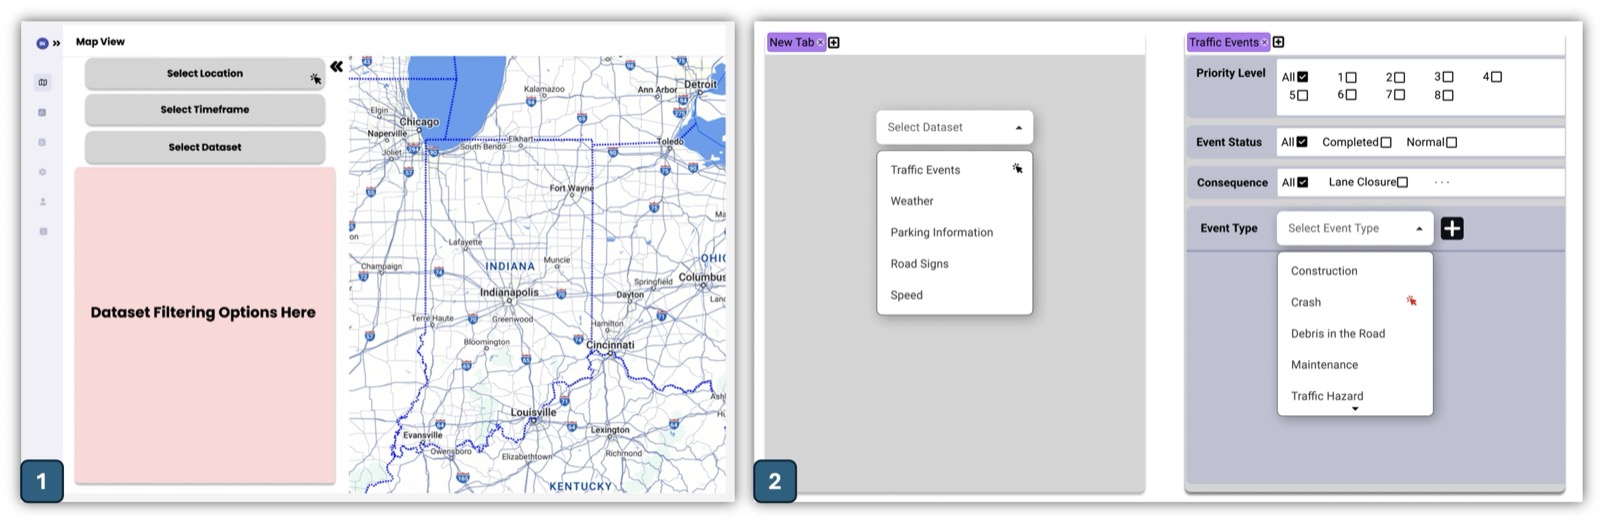

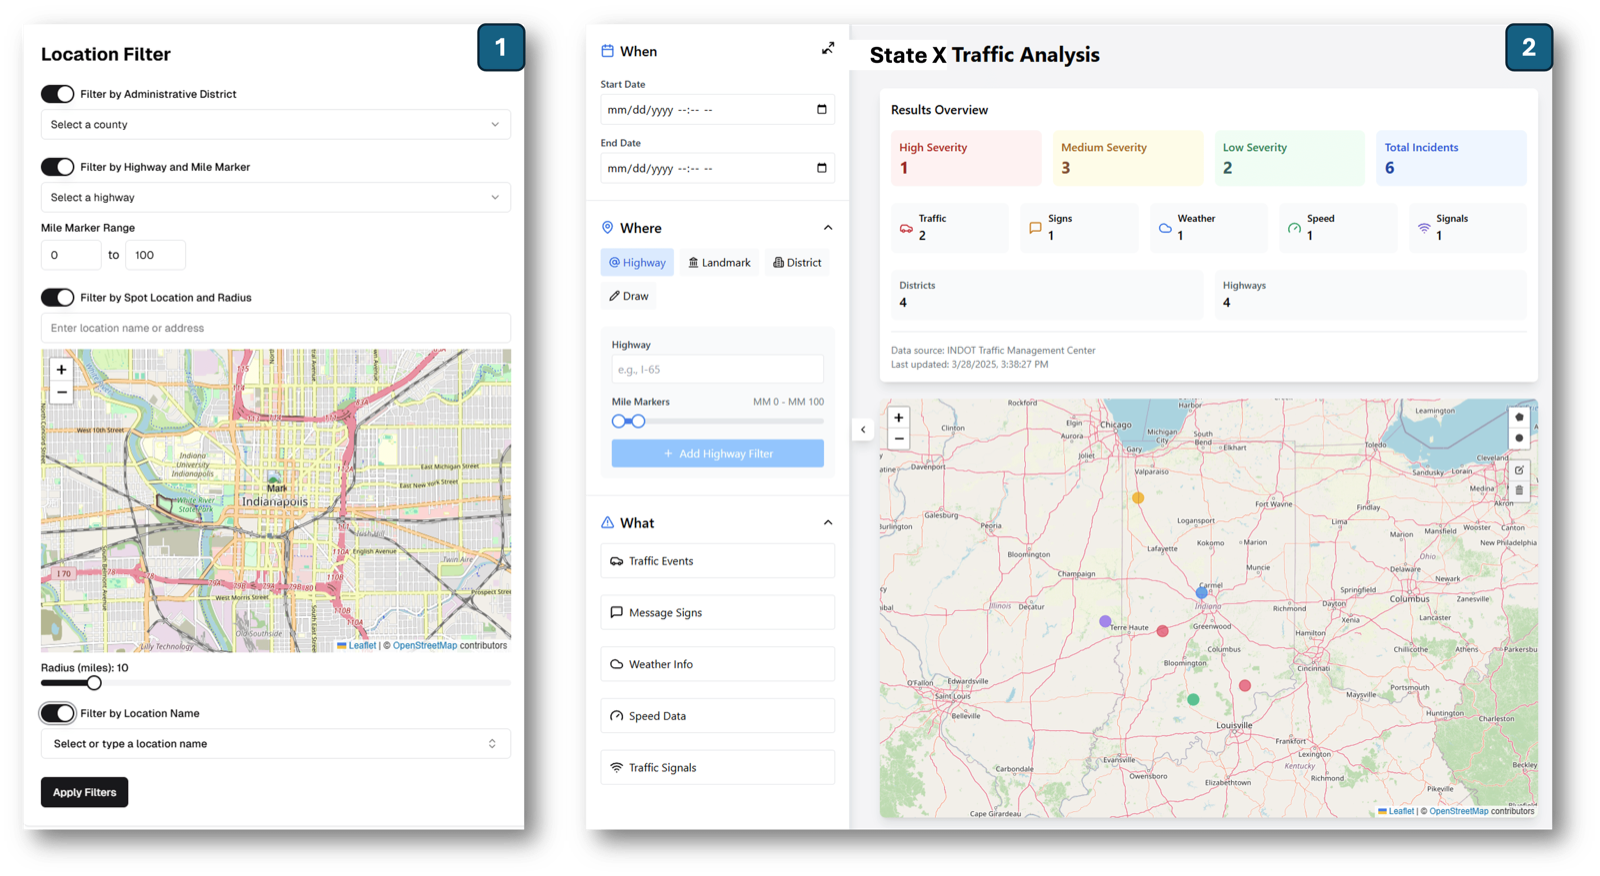

 Bu bir kanıt değil, bir imkân göstergesi. NN/g bu noktayı kendisi işaretliyor: Purdue örneği tek bir projeye odaklanan sıralı bir vaka analizi, kontrollü bir deney değil. Yani “AI prototipleme daha iyi araştırma üretir” sonucunu değil, “artık kurulması ve test edilmesi mümkün hâle geldi” sonucunu destekliyor. Metodolojik ayrımı kaynağın kendisi kuruyor — aktaranların çoğu bu cümleyi atlıyor.
AI ile karmaşık arayüz prototiplemenin 6 adımı
NN/g’nin tarif ettiği süreçte ilk iki adım araca hiç dokunmadan yapılıyor — çıktının kalitesini belirleyen de tam olarak bu iki adımdaki düşünme işi.


- Prototipin ne yapması gerektiğine karar verin. Aracı açmadan önce sorun: araştırma sorularımı cevaplamak için prototip hangi etkileşim seviyesini desteklemeli? Hangi davranışlar, durumlar, veriler çalışmak zorunda? Bazen basit bir prototip zaten yeterlidir.
- Tasarım kararlarınızı verin. Yerleşim, hiyerarşi, etkileşimler ve uç durumlar — boş durum, hata durumu dahil — nasıl görünmeli? Yazılı hâle getirin. 4. adımdaki prompt’un kalitesi buradaki işe bağlı.
- Veriyi toplayın. İki seçenek var: ürününüzden gerçek veri dışa aktarın (kurumunuzun veri politikasına uyun, kişisel veri yüklemeyin, aracın kendi veri politikasını da okuyun) ya da Claude, Gemini, ChatGPT gibi bir araca kendi belirlediğiniz kriterlere göre sentetik veri seti ürettirin.
- Prompt’u yazın. İlk iki adımdaki kararlar ile üçüncü adımdaki veri tek bir ayrıntılı prompt’ta birleşir: istediğiniz yerleşim, etkileşimler, uç durumlar ve veri dosyası. Eskiz, wireframe veya mevcut tasarımları da ekleyin. Markdown, dil modellerinin en kolay ayrıştırdığı format.
- Bir prototipleme aracına verin. Cursor, v0 ve Figma Make ayrıntılı bir prompt’tan çalışan etkileşimli prototip üretebiliyor. Seçim, ihtiyacınız olan kontrol miktarına ve kod düzenleme konusundaki rahatlığınıza bağlı.
- Çıktıyı düzeltin ve yineleyin. İlk çıktı büyük ihtimalle her şeyi doğru yapmayacak. Yerleşimi ayarlamak, etkileşimleri düzeltmek için ileri geri gidin. Memnun kaldığınızda, teste girmeden önce küçük bir pilot koşu yapın — prototipin kendisi yeni bir yanlış anlaşılma üretmesin.
Küçük bir not: NN/g makalenin gövdesinde süreci “beş adım” diye tanıtıyor ama hem maddelerde hem kendi süreç şemasında altı adım var. Şemadaki sayı doğru olan.
İki tuzak: kararları araca bırakmak ve sadakat tuzağı
Makalenin en çok altı çizilen kısmı burası. Birinci tuzak: tasarım kararlarını araca bırakırsanız araç boşlukları kendi doldurur. NN/g’nin ifadesiyle bu araçlar içerik yerleşimini veya görsel hiyerarşiyi doğası gereği anlamıyor; işe yarar çıktı için bilgili bir tasarımcının ayrıntılı yönlendirmesine ihtiyaç duyuyorlar. Değişen şey kararların kime ait olduğu değil, kararları ne kadar hızlı test edilebilir bir şeye çevirebildiğiniz.
İkinci tuzak daha sinsi: sadakat tuzağı. Cilalı görünen, gerçek veri gösteren, tam etkileşimli bir prototip gördüğünde birinin “harika görünüyor, bunu direkt yayına alsak olmaz mı?” demesi makul bir sorudur. Tehlike, cilanın insanları prototipi geliştirmeyi bırakmaya ikna etmesi.

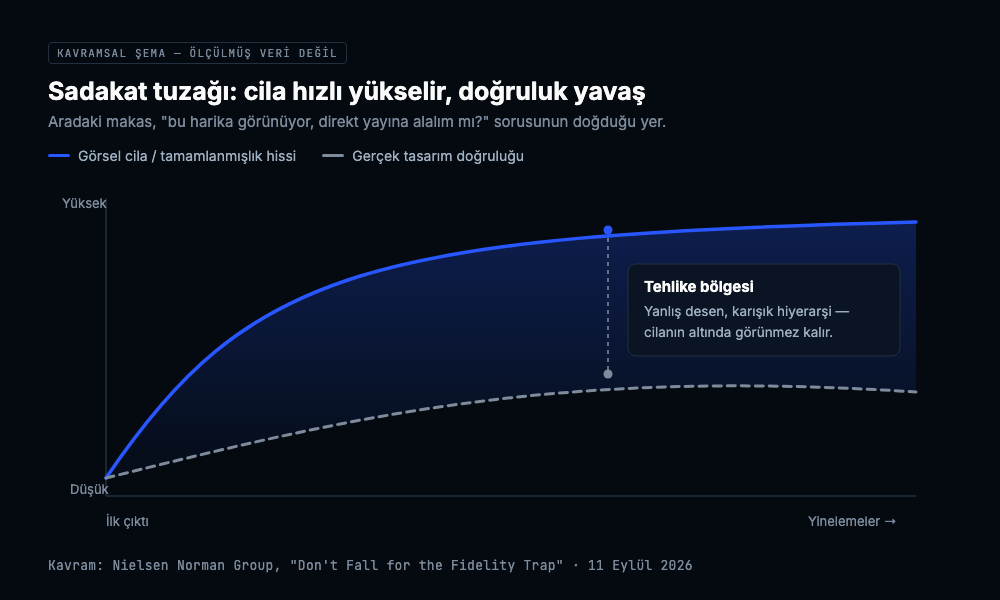
AI üretimi prototipler tamamlanmış görünürken içlerinde her türden varsayım ve yanlışlık barındırabiliyor: duruma uygun olmayan tasarım deseni, karışık hiyerarşi, gereksiz yere tekrar eden öğeler. NN/g’nin önerdiği panzehir tek cümlelik: prototip yayına itilmeden önce tasarım bilgisi güçlü birinin onu incelemesini sağlayın.
Bunu kendi ekibinizde nasıl uygularsınız?
Yöntemi bugün deneyecekseniz, kaynağın kendi vurgularından çıkan pratik sıra şu:
 En karmaşık ekranınızla başlayın, en basitiyle değil. Yöntemin getirisi durum sayısıyla büyüyor; giriş ekranını AI ile prototiplemek zaman kazandırmaz.
- Uç durumları prompt’a yazın. Boş durum ve hata durumu yazılmazsa araç bunları kendi uydurur — ve testte tam bu ekranlara denk gelirsiniz.
- Veri konusunda sentetikle başlayın. Gerçek veriyi kullanmak kurum politikası ve aracın veri işleme koşulları demek; sentetik veri seti bu iki engeli baştan aşıyor.
- Prototipi paylaşırken ne olduğunu söyleyin. “Bu bir araştırma prototipi, üretim kodu değil” cümlesi sadakat tuzağının en ucuz panzehiri.
 En karmaşık ekranınızla başlayın, en basitiyle değil. Yöntemin getirisi durum sayısıyla büyüyor; giriş ekranını AI ile prototiplemek zaman kazandırmaz.
Bu tartışma, AI’ın ürün ekiplerinde rolleri bulanıklaştırması meselesinin doğrudan bir uzantısı: tasarımcı artık kodlayan kişi değil, ama kodun ne yapacağını tarif eden kişi hâline geliyor. Aynı şekilde niyet temelli arayüzler ve sesli AI arayüz kalıpları gibi belirli olmayan davranışa dayanan tasarımlar, statik prototiple test edilemeyen türün en hızlı büyüyen kısmı. Terminolojide takılırsanız NN/g’nin yapay zeka sözlüğü işinizi kolaylaştırır.
Sık sorulan sorular
AI prototipleme için hangi araçlar kullanılıyor?
NN/g’nin makalede adını verdiği prototipleme araçları Cursor, v0, Bolt ve Figma Make. Sentetik veri seti üretmek içinse Claude, Gemini ve ChatGPT gibi genel amaçlı araçlar öneriliyor. Hangisini seçeceğiniz ihtiyacınız olan kontrol miktarına ve kod düzenleme konusundaki rahatlığınıza bağlı.
AI prototipine gerçek kullanıcı verisi yüklenebilir mi?
Yüklenebilir ama iki koşulla: kurumunuzun veri politikasına uymanız ve kişisel veri içeren hiçbir alanı yüklememeniz gerekiyor. NN/g ayrıca kullandığınız aracın kendi veri politikasını okumanızı da öneriyor — verinizin aracın sahibi şirket tarafından nasıl kullanılabileceğini bilmeden yüklemeyin. Ramp’ın testinde katılımcılara kendi temizlenmiş verileriyle yüklenmiş prototipler verilmişti.
AI ile üretilen prototip doğrudan yayına alınabilir mi?
Hayır. NN/g bunu açıkça uyarı olarak koyuyor: AI üretimi yüksek sadakatli prototipin üretime hazır olduğunu varsaymayın. Cilalı görünse de yanlış tasarım deseni, karışık hiyerarşi veya gereksiz tekrar eden öğeler barındırabilir. Öneri, prototip yayına itilmeden önce tasarım bilgisi güçlü birinin incelemesi.
Purdue çalışması AI prototiplemenin daha iyi araştırma ürettiğini kanıtlıyor mu?
Hayır ve bunu NN/g’nin kendisi belirtiyor. Purdue örneği tek bir projeye odaklanan sıralı bir vaka analizi, kontrollü bir deney değil. Örneği “neyin kurulup test edilebilir hâle geldiğinin göstergesi” olarak okumak gerekiyor, “AI prototipleme daha iyi araştırma üretir” kanıtı olarak değil. Çalışmanın akademik künyesi: Tianyi Li, Tanay Maheshwari, Alex Voelker (2025), ACM Collective Intelligence 2025.
Her araştırma sorusu için AI prototipi gerekli mi?
Gerekli değil. NN/g, karmaşıklığı düşük arayüzlerde statik prototiplerin birçok araştırma sorusunu hâlâ cevapladığını söylüyor. Yerleşim, görsel hiyerarşi ve terminoloji testi için statik ekran yeterli. AI prototipi, sorunuz sistemin cevap verme davranışıyla ilgili olduğunda — filtreler, dashboard’lar, konuşma tabanlı arayüzler — devreye giriyor.
Kaynaklar
- Megan Chan, “Test Complex Interactions Earlier with AI Prototyping” — Nielsen Norman Group, 11 Eylül 2026
- Tianyi Li, Tanay Maheshwari, Alex Voelker, “User-Centered Design with AI in the Loop: A Case Study of Rapid User Interface Prototyping with Vibe Coding” — ACM Collective Intelligence 2025 (Purdue vaka analizi)
Bir Yorum Yazın