
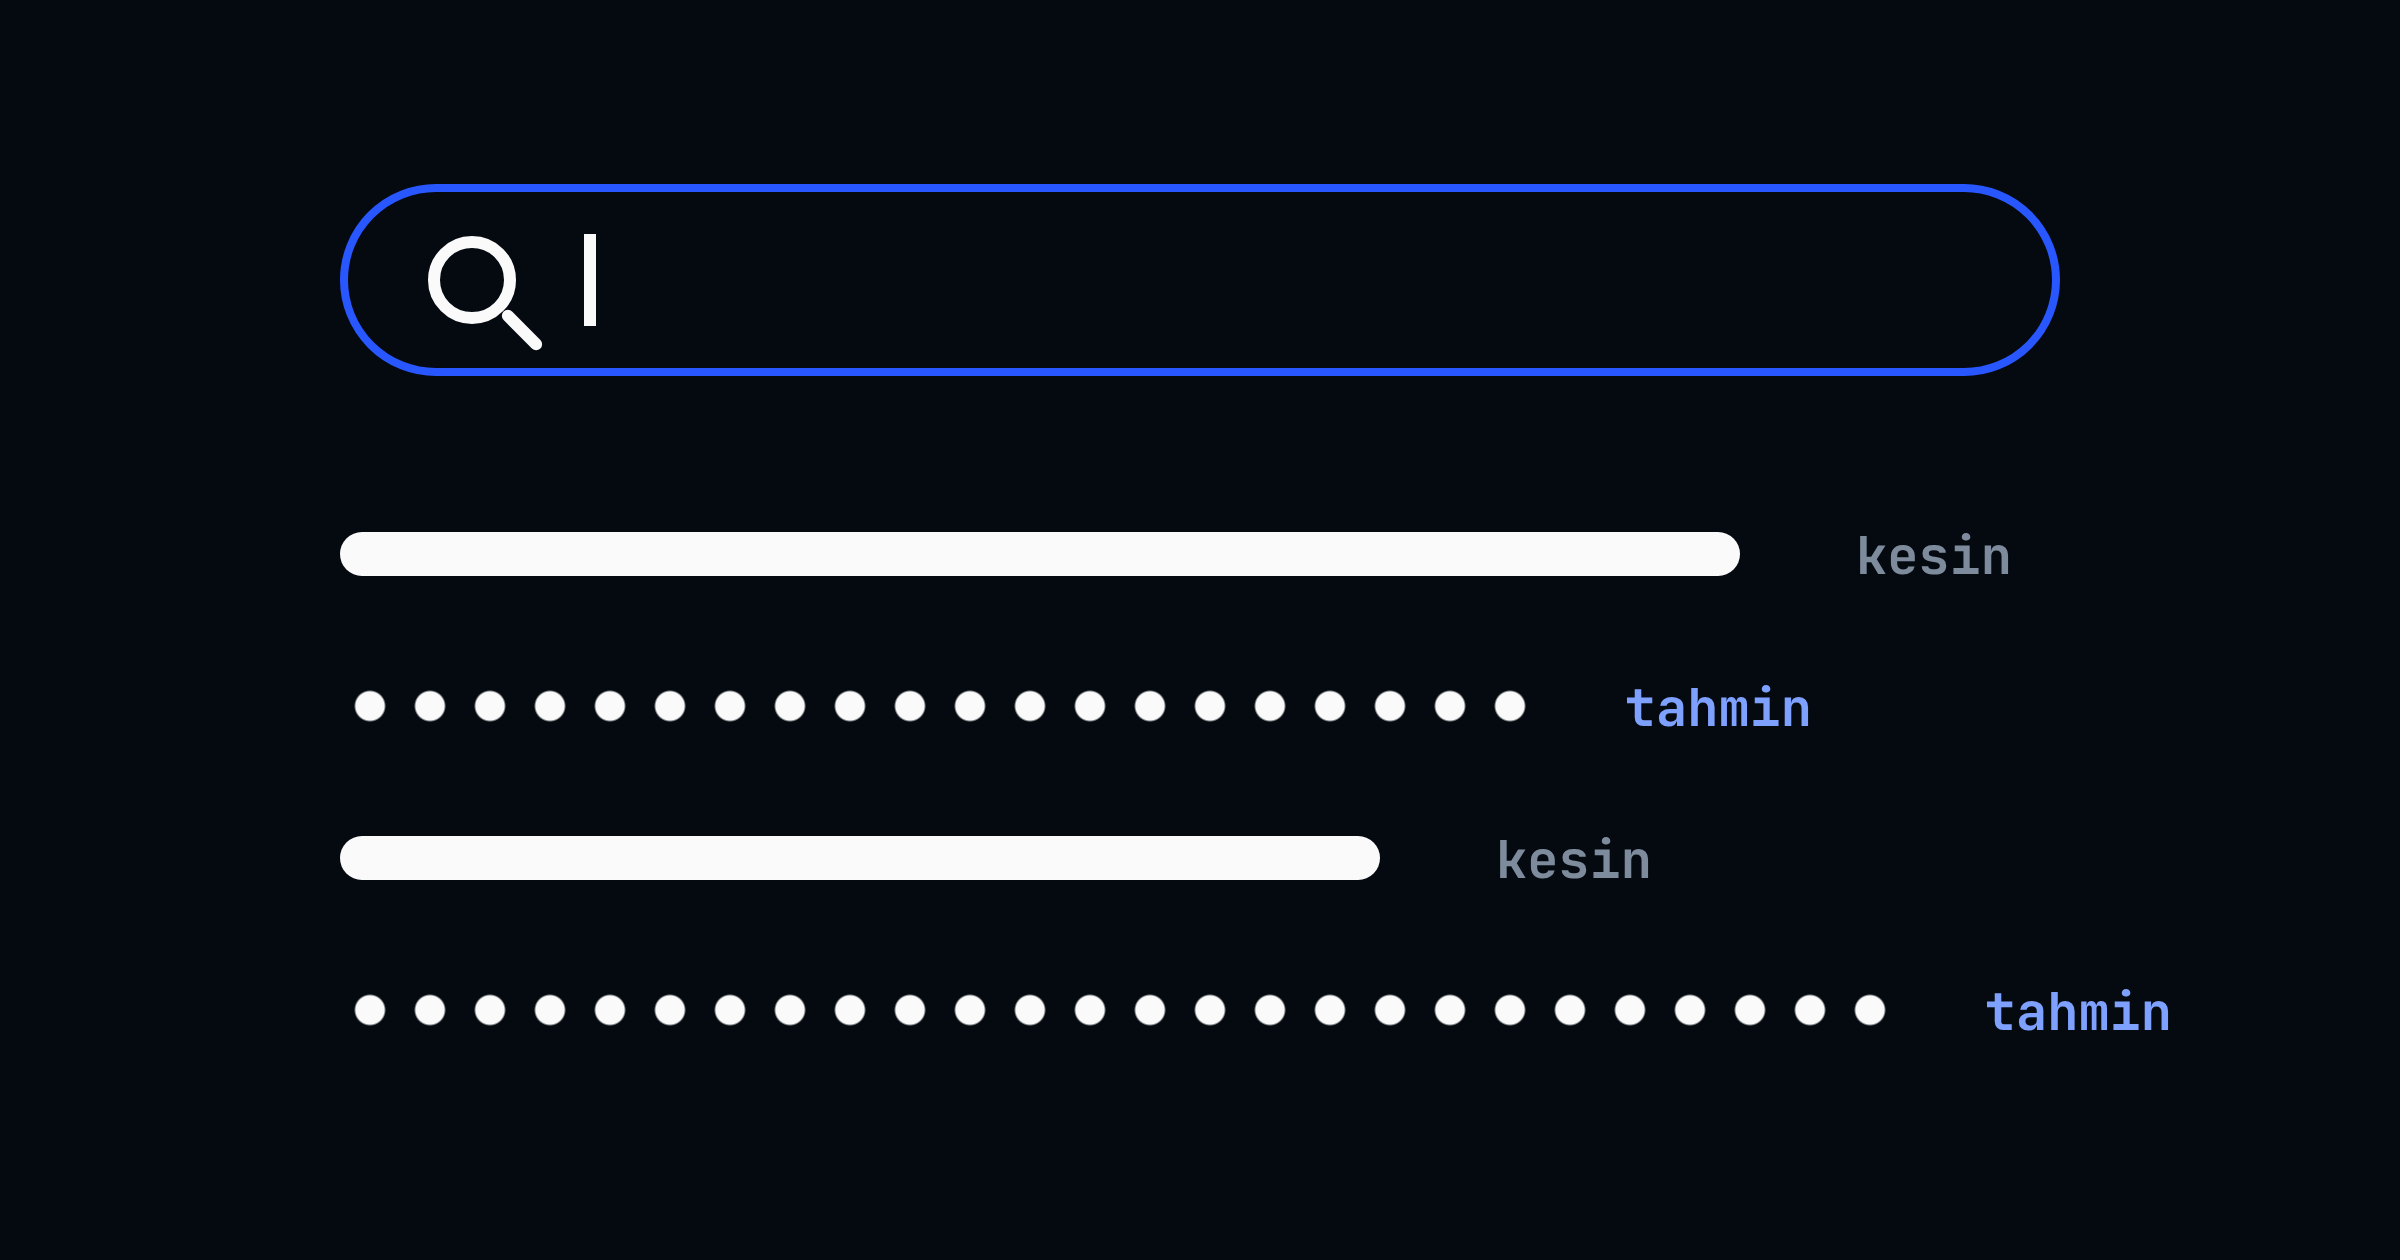
Google’ın yapay zekâ ürünlerinin “bozuk” hissettirmesinin sebebi büyük ihtimalle modelin zayıflığı değil. Olasılıksal bir katmanın, kesin sonuç vaat eden arama arayüzüne aynı yazı tipi ve aynı kendinden emin tonla yerleştirilmesi asıl sebep. Danışman Hitesh Sarda 28 Eylül 2026 tarihli yazısında bu tezi savunuyor ve sorunun model kalitesinden değil, ürün kararlarından kaynaklandığını söylüyor.
Bu yazı Google’ı eleştirmekten çok, kendi ürününe AI ekleyen her ekip için bir kontrol listesi çıkarıyor. Hangi ekranınız tahmin kaldırır, hangisi kaldırmaz? Okuyucuya bunu nasıl söylersiniz? Bir de kullanıcı tarafı var: AI özeti olmadan arama nasıl yapılır?
Google aramasında ne değişti?
Sarda üç somut davranış sayıyor: Bir kitaptan alıntı yapıştırdığınızda arama bunu sizin görüşünüz gibi okuyor. Belirli bir sayfayı sorduğunuzda bağlantıyı açmıyor, sayfada muhtemelen ne yazdığını tahmin ediyor. Tam ifade araması ise artık bulanık eşleşmeler döndürüyor. Yazar bu listeyi o hafta çok konuşulan bir blog yazısından ve altındaki yorumlardan derlediğini belirtiyor.
Yazarın vurguladığı nokta şu: Bunların hiçbiri model kalitesi sorunu değil. Sarda’ya göre Gemini, kamuya açık karşılaştırmalarda yetkin bir model. Hata modelin üstünde, yani modelin nereye konduğu, neyi tahmin ettiğini nasıl itiraf ettiği ve çıkış kararında ürün sezgisi olan birinin bulunup bulunmadığı katmanında. Model tarafındaki tartışmayı Gemini 4 Argon yazımızda ele almıştık.
Arama kutusunun sözü: aynı sorgu, aynı sonuç
Bir arama kutusu örtük bir söz verir: Aynı sorgu aynı, doğrulanabilir ve sıralı sonuç listesini getirir. Gazeteciler intihal kontrolü için ayırt edici cümleleri yapıştırdı, geliştiriciler web’i bir kod tabanı gibi taradı. Bu söz belirlenimci olduğu için arayüz onu yüksek sesle, otoriter bir tipografiyle söyleyebiliyordu.
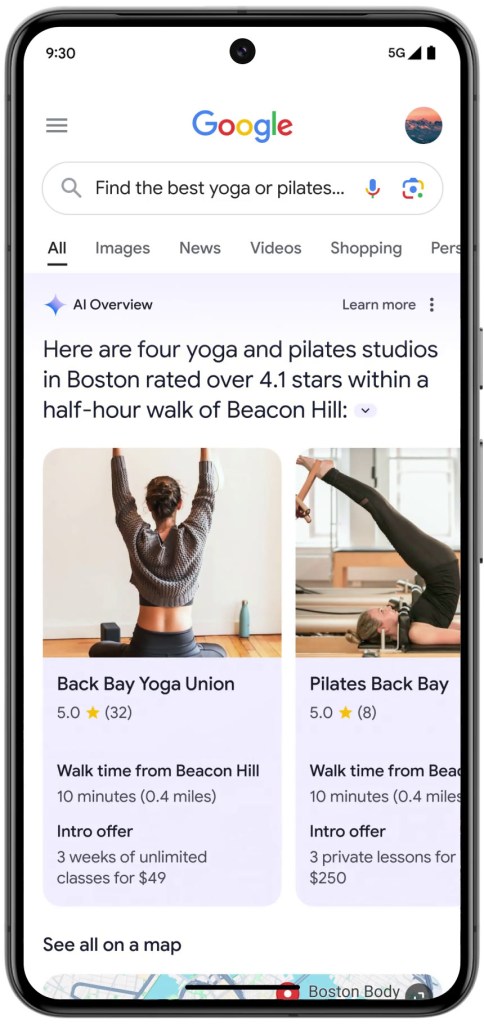
AI özetleri bu arayüze aynı yazı tipiyle ve aynı tonla girdi; söz yeniden müzakere edilmedi. Sayfada “bu satır bir tahmin, şu satır bir arama sonucu” diyen bir ayrım yok ya da çok zayıf.
| Klasik arama sonucu | AI özeti | |
|---|---|---|
| Doğası | Belirlenimci (aynı sorgu, aynı sıralı liste) | Olasılıksal (her seferinde üretilen metin) |
| Doğrulama | Sonuç zaten bir kaynak | Kaynağa gitmek ek adım ister |
| Arayüzdeki ses | Otoriter yazı, kesin dil | Aynı yazı, aynı kesin dil |
| Belirsizlik işareti | Gerek yok | Küçük, gri bir dipnot |
Google bu riski kabul ediyor mu?
Evet, yardım sayfasında. Google’ın AI Overviews destek sayfası “AI Overviews can and will make mistakes” (hata yapabilir ve yapacaktır) diyor ve önemli bilgileri birden fazla yerde kontrol etmeyi öneriyor. Aynı sayfaya göre özellik kapatılamıyor. Sorun uyarının varlığı değil; uyarının sonuç ekranında değil, yardım sayfasında durması.
Doğrulama vergisi: hiçbir panoda görünmeyen maliyet
 Sarda’nın en keskin gözlemi şu: AI’ın verdiği cevabı işlem yapmadan önce kontrol etme alışkanlığı, kullanıcının her sorguda ödediği küçük bir vergi. Bu kontrol çoğu zaman Google’a başka bir soru sormak demek. Bu yüzden etkileşim metrikleri sağlıklı bile görünebilir.
Öte yandan Pew verileri, kullanıcıların özetteki kaynaklara nadiren tıkladığını gösteriyor; yani pek çoğu bu vergiyi hiç ödemiyor olabilir:
İki eğilim aynı anda doğru olabilir: Kontrol edenler görünmez bir ek iş yapıyor, etmeyenler hatalı bilgiyi taşıyor. İkisi de güveni yavaşça aşındırıyor. Bu aşınmayı ölçülebilir hale getirmek, UX yatırımını yönetime savunurken kullanılabilecek en güçlü argümanlardan biri.
Olgu mu vaat ediyor, öneri mi? Her yüzey için tek soru
Sarda, ürününe AI ekleyen ekiplere yol haritasının tamamı için tek cevap değil, her yüzey için tek bir soru öneriyor: Bu özellik bir olgu mu vaat ediyor, yoksa bir öneri mi sunuyor?
Bu ayrım, varsayılanların gücüyle birleşince daha da önem kazanıyor. Kullanıcıların büyük kısmı ayarlara dokunmadığı için (varsayılan değer yazımız), olgu yüzeyine varsayılan olarak yerleştirilen AI katmanı fiilen herkesin deneyimi oluyor.
Arayüzde tahmini nasıl belli edersiniz?
Google’ın kendi tasarım rehberi People + AI Guidebook bu soruya doğrudan cevap veriyor. Hedef “körü körüne güven” değil, güvenin doğru ayarlanması (calibration):
 Sınırları erken söyleyin: Rehber, ürünün yapabildiklerini ve yapamadıklarını beklenti oluşturmak için açıkça ve erkenden anlatmayı öneriyor.
- Yanılabileceğini işaretleyin: Rehbere göre bir tahminin yanlış olabileceğini belirtmek, kullanıcının o tahmine daha az güvenmesini sağlar ve uzun vadede hayal kırıklığını azaltır.
- Güven skorunu yalnızca karar değiştiriyorsa gösterin: Rehber, yanıltıcı derecede yüksek bir güven göstergesinin sonucu körü körüne kabul ettirebileceği uyarısını yapıyor.
- Veri kaynağını açıklayın: Her AI tahmini veriye dayanır; rehber, kaynakların açıklamanın parçası olması gerektiğini söylüyor.
- Görsel dili ayırın: Bu bizim çıkarımımız: Üretilmiş metin, aramadan gelen sonuçla aynı tipografiyi ve aynı kesin tonu paylaşmamalı. Dipnotta küçük gri bir uyarı yeterli bir ayrım değil.
Sesli arayüzlerde bu ayrım daha da zor, çünkü görsel ipucu yok. O tarafı sesli yapay zekâ arayüzlerinin tasarım kalıplarında anlatmıştık. Kavramlara yabancıysanız NN/g’nin yapay zekâ sözlüğü iyi bir başlangıç.
Google’da AI özeti olmadan nasıl arama yapılır?
Google’ın yardım sayfasına göre AI Overviews kapatılamıyor, ama yalnızca bağlantılardan oluşan sonuç görmek mümkün:
 Aramayı yapın: Sorgunuzu her zamanki gibi yazın.
- “Web” filtresini seçin: Sonuç sayfasındaki filtrelerden “Web”e geçin. Google’a göre bu filtre, AI Overviews gibi özellikler olmadan yalnızca metin bağlantılarını gösterir.
- Hatalı özeti bildirin: Bir özet yanlışsa altındaki başparmak aşağı simgesine basıp “Report a problem” seçeneğiyle bildirebilirsiniz.
- Önemli bilgiyi çapraz kontrol edin: Google’ın kendi tavsiyesi de bu: Önemli bilgiyi birden fazla kaynakta doğrulayın.
Conway yasası: Kuruluş şeması ürüne nasıl sızar?
Sarda’nın ikinci tezi kurumsal. Yazının aktardığı bir yorumda eski bir Google çalışanı, mühendislerin gerçek kullanıcılarla konuşmaktan caydırıldığı bir kültür tarif ediyor; bu iddia yorumcunun beyanı ve bağımsız olarak doğrulanmış değil. Yazar bunu Conway yasasıyla okuyor: Yazılım, onu üreten kurumun iletişim yapısını yansıtır.
Ayrı hedeflere göre özellik çıkaran ve kullanım verisini geri taşıyan kalıcı bir kanalı olmayan ekipler, kuruluş şemasını andıran bir ürün çıkarır: parçalı, yerel olarak optimize edilmiş ve kimsenin uzlaştırmadığı. Sarda’nın önerisi, mühendislerin kullanıcı deneyimini duymasını sağlayan “gösterişsiz bütçe kalemini” korumak.
Sık sorulan sorular
Google AI Overviews güvenilir mi?
Google’ın kendi ifadesiyle AI Overviews “hata yapabilir ve yapacaktır”. Google, önemli bilgileri birden fazla kaynakta kontrol etmeyi öneriyor. Hızlı bir başlangıç noktası olarak işe yarar; sağlık, hukuk ve para gibi konularda kaynağa gitmeden karar vermeyin.
Google AI Overviews nasıl kapatılır?
Kapatılamaz; Google yardım sayfası bunu açıkça söylüyor. Arama yaptıktan sonra sonuç sayfasında “Web” filtresini seçerseniz yalnızca metin bağlantılarından oluşan sonuçlar görürsünüz.
AI özeti neden yanlış bilgi verebiliyor?
Çünkü özet, bir veritabanından çekilen kayıt değil; olasılıksal bir modelin ürettiği metin. Aynı sorguda farklı ifadeler üretebilir ve kaynağı yanlış yorumlayabilir. Arayüz bunu kesin sonuçla aynı dille sunduğunda hata daha inandırıcı görünür.
Ürünüme yapay zekâ eklerken nereden başlamalıyım?
Her ekran için şu soruyu sorun: Bu ekran bir olgu mu vaat ediyor, öneri mi sunuyor? Öneri yüzeyleri (otomatik tamamlama, taslak üretimi) ilk aday. Olgu yüzeylerine AI ekleyecekseniz üretilmiş içeriği görsel olarak ayırın ve kaynağını gösterin.
Güven kalibrasyonu (trust calibration) nedir?
Kullanıcının AI sistemine her durumda değil, sistemin güvenilir olduğu durumlarda güvenmesi; diğer durumlarda kendi yargısını kullanmasıdır. Google’ın People + AI Guidebook rehberi bunu AI ürün tasarımının temel hedeflerinden biri olarak tanımlıyor.
Bir Yorum Yazın